「学習に使わない」「保存しない」と公式に書いているAIのAPI で、別の顧客のプロンプトが応答に混ざりました。
Cloudflare の公表によると、Workers AIのGLM 5.3で、8月27日から9月9日まで155件の応答に他社のデータが入っていました。当たるのはこの期間にGLM 5.3を使っていた会社だけで、経緯と原因は10月27日の記事 にあります。
ただ、Workers AIを使っていない会社にも無関係な話ではありません。AIのAPIの確認を「学習に使われない」で終えているなら、もう一段聞くことがあります。
短いプロンプトだけの会社も、対象外とは言えない
「68万トークンを超えるプロンプトなんて送っていない、うちは関係ない」。そう読みたくなりますが、この長さは混ざった応答を受け取った側の条件です。
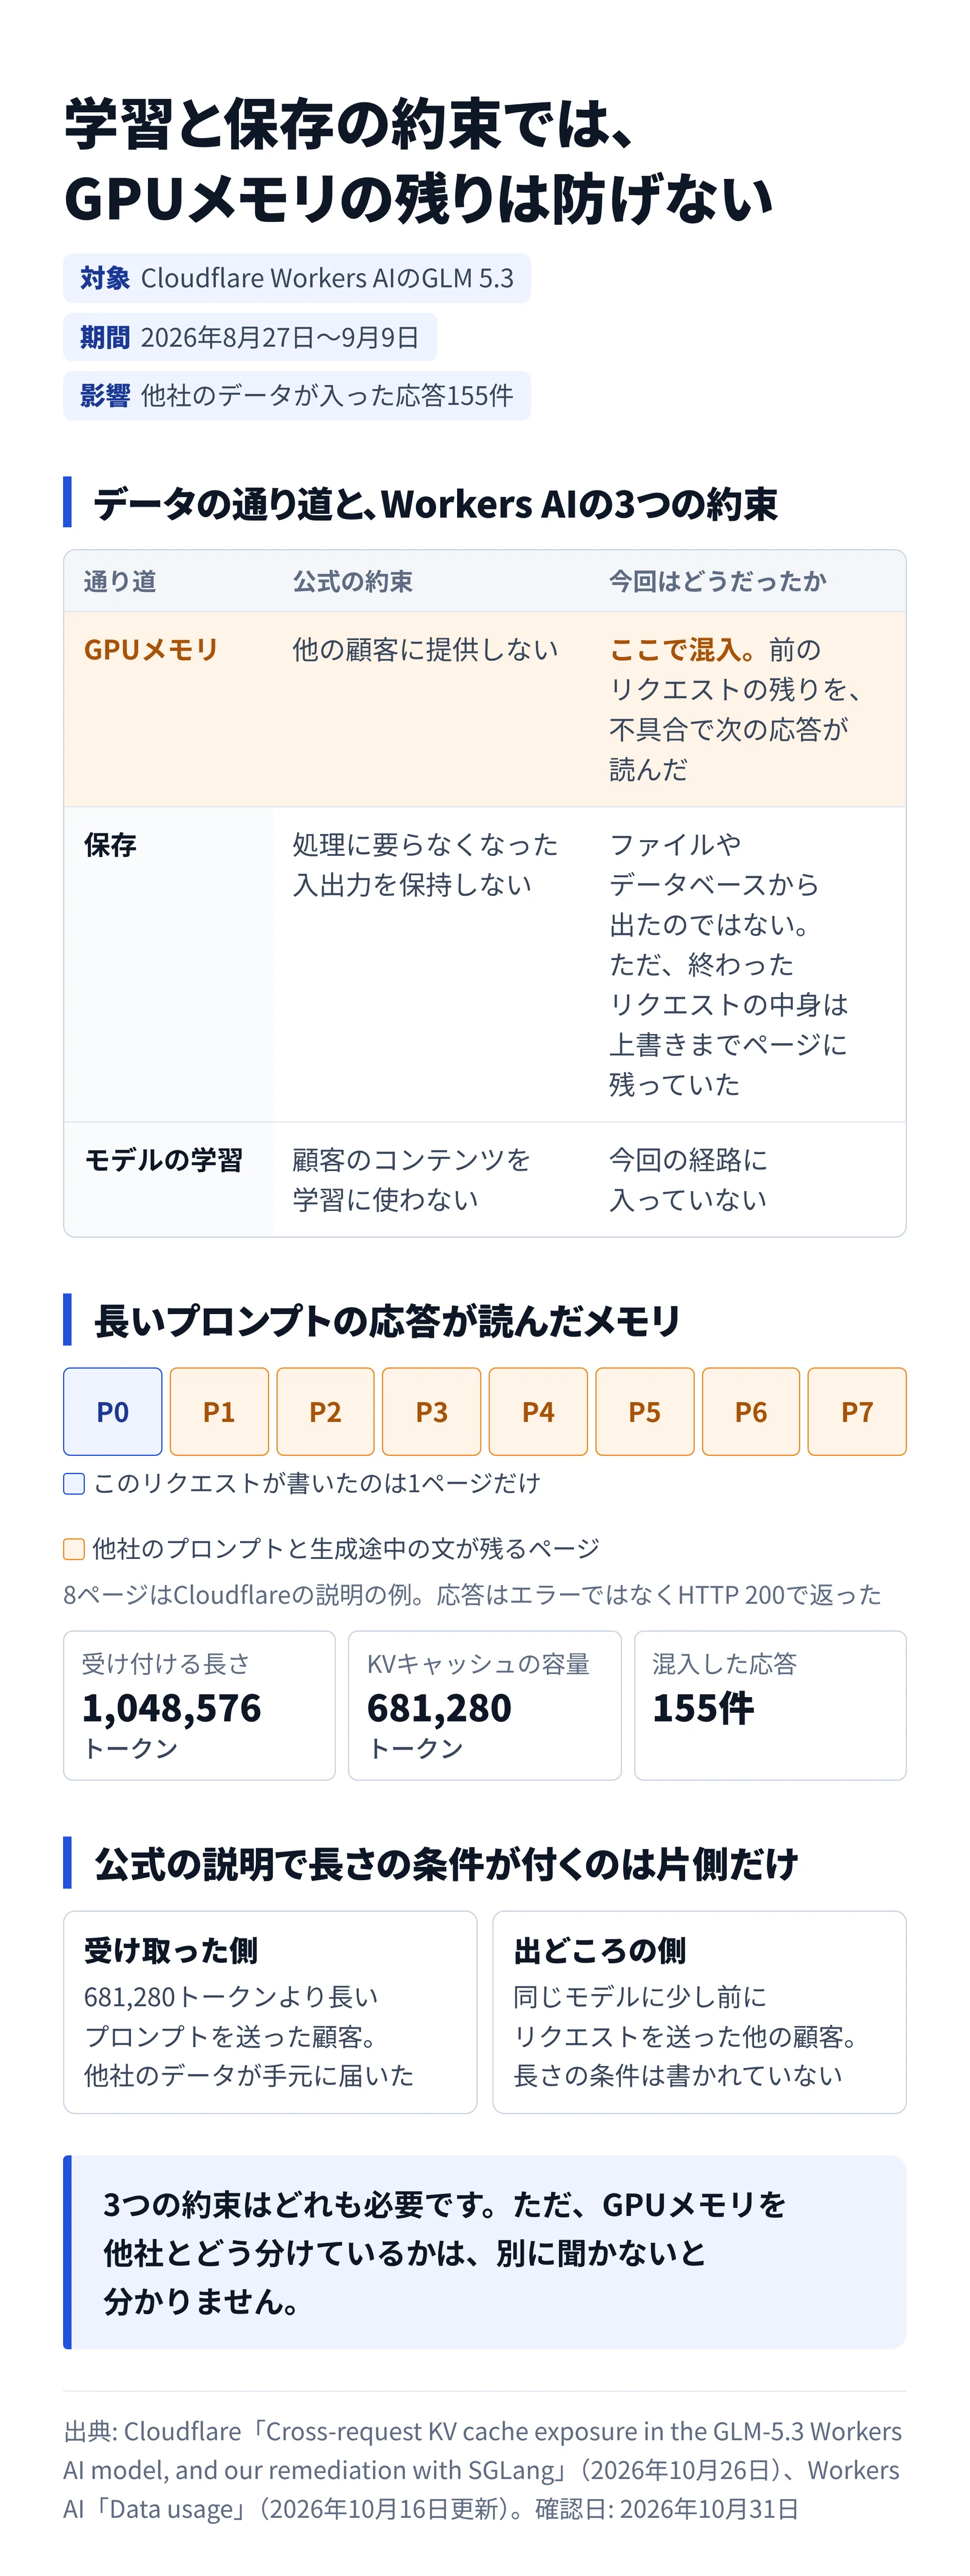
Cloudflareの説明では、681,280トークンより長いプロンプトへの応答が、メモリに残った前のリクエストの中身を読みました。残っていた中身は、同じモデルに少し前にリクエストを送った他の顧客のプロンプトと、生成途中の文です。
報告したKnosticのGadi Evron氏が自分の試験で直接見たものには、人名、取引先 名、請求書番号、ユーロの金額、支払日、ソースコード、ファイルパス、エージェントの作業記録がありました。
出どころの側の長さについて、Cloudflareの投稿は何も書いていません。
立場
公式の記述から読める条件
起きたかもしれないこと
受け取った側
8月27日〜9月9日に@cf/zai-org/glm-5.3へ、681,280トークンより長いプロンプトを送った
他社のデータが自社の手元に届いた
出どころの側
同じ期間に同じモデルへリクエストを送った
自社のデータが他社の応答に出た
対象外
Workers AIのほかのモデルや、Cloudflareのほかのサービスだけを使っている
この件で急ぐことはない
線を引く軸は長さではなく、この期間にGLM 5.3を呼んだかどうかでしょう。Cloudflareと直接の契約 がなくても、提供元を振り分けるサービス経由なら当たることがあります。モデルを止めたのは日本時間の9月9日23時で、修正して戻したのは10日4時40分です。
名前が紛らわしいのですが、KVキャッシュはGPUメモリに置く計算の途中結果で、ストレージのWorkers KVとは別のものです。
SGLangを自社で動かす会社は、別の軸で見ます。不具合が出るのはprefillとdecodeを分けた構成で、1台で動かす構成ではエラーが返っていました。
学習と保存の約束では、GPUメモリの残りは防げない
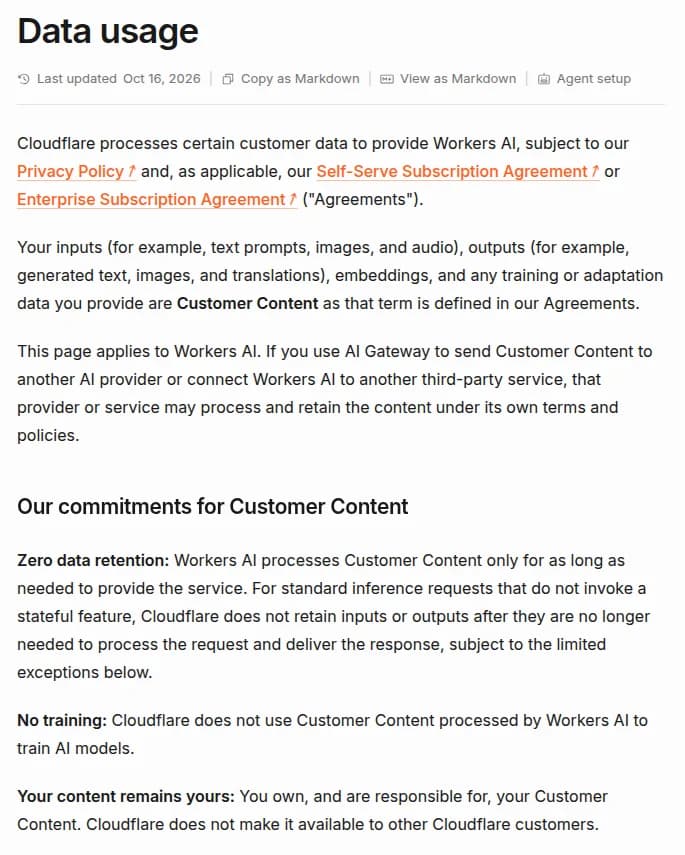
Workers AIのデータの扱いのページには、3つの約束が並んでいます。処理に要らなくなった入出力は保持しないこと、顧客のコンテンツを学習に使わないこと、他の顧客に提供しないことです。
Workers AIのデータの扱いのページ。保持しない、学習しない、他の顧客に提供しないと書いている 出典: Cloudflare「Data usage」(Workers AI) (引用) 今回の経路に当てはめると、学習の約束は関係がありません。モデルの学習を通らず、前のリクエストが残したメモリを次の応答が読んだからです。
保存の約束は、もう少し微妙です。データが出たのはファイルやデータベースではなくGPUメモリでした。ただ、終わったリクエストの中身は、上書きされるまでページに残っていました。これを「保持」と呼ぶかをCloudflareは書いていません。
3つ目の約束には反する結果になりました。とはいえ、不具合で起きたことで、Cloudflareが意図して渡したわけではありません。セルフサーブ契約の6.2にも「We cannot guarantee that our security procedures will be error-free」とあり、不具合がないことまでは約束していません。
Workers AIの3つの約束と、混入が起きた場所。公式の説明で長さの条件が付くのは受け取った側だけ 作成: 編集部 / 出典: Cloudflare「Cross-request KV cache exposure in the GLM-5.3 Workers AI model, and our remediation with SGLang」「Data usage」 GPUメモリのページは、リクエストの間に消去されません。次のリクエストが上書きするだけです。Cloudflareは、推論エンジンでは一般的なやり方で、最高の性能を得るために必要だと説明しています。つまり、他社のデータとの境目を守っているのは、ページの持ち主を管理するエンジンのソフトウェアです。
修正後も、この前提は変わっていません。Cloudflareの投稿によると、解放時にページを消去する案はまだ提案の段階で、転送の中身を検証する仕組みも対応モデルを広げている途中です。
this incident is a reminder that the next bug will have a shape we have not seen.
出典: Cloudflare「Cross-request KV cache exposure in the GLM-5.3 Workers AI model, and our remediation with SGLang」
次の不具合は、まだ見たことのない形で来る。当事者が自分でこう書いているのは、率直だと感じました。
「学習に使わない」は、今も必要な確認です。法人向け生成AIの地図 でも、製品ごとに学習の記載を確認しました。足りないのは、その先の問いです。
「キャッシュは分離」の一文では答えにならない
AIのAPIの資料を読むと、キャッシュの分離はたいてい書いてあります。4社のキャッシュ機能の説明から、分離の単位を抜き出しました(英字順、10月31日に確認)。
事業者
公式の記述
分離の単位
Anthropic
Caches are isolated between organizations.
組織(提供形態によりワークスペースも)
Google(Gemini Enterprise Agent Platform)
It's scoped to your project and is never served to another project.
プロジェクト
Microsoft(Azure OpenAI)
The system doesn't share prompt caches between Azure subscriptions.
サブスクリプション
OpenAI
Caches are not shared across organizations
組織
どれもプロンプトの計算結果を再利用する機能の説明で、他社の結果は使い回さないという話です。今回の不具合はキャッシュのヒットではありません。拒否されたリクエストが、自分で書いていないページを読みました。
読んだ4つのページには、メモリを再利用するときに消すのか、持ち主をどう確認するのかまでは書かれていません。もっとも、4社に同じ不具合があるという意味ではなく、別の資料で説明している可能性もあります。聞く層が違う、というだけのことです。
推論エンジンの名前を聞く理由もあります。SGLangのREADMEには、AIの研究機関やクラウド、企業、大学の本番で動いているとあります。開発元の投稿によると、中断したリクエストのデータが別のリクエストに混ざりうる競合状態が、今回とは別にありました。prefillとdecodeを分ける構成の既定の設定で、2025年初めから今年の修正版まで残っていたといいます。1
しかも開発元によると、この競合状態は、発生したかどうかを運用者が確かめる確実な方法がありません。Cloudflareが155件と数えられたのは、長さを超えたリクエストが毎回同じ動きをしたからでしょう。だから事業者が「影響はありません」と答えたら、その根拠まで聞く価値があります。
残ったメモリの事故は、AIが初めてではない
メモリの残りから他人のデータが出る事故には前例があります。原因はそれぞれ違いますが、2件の原文を読んで並べました。
事例
公表
出たデータ
読むのに要ること
出た先
Cloudflareのパーサーの不具合
2017年2月
HTTP Cookie、認証トークン、POSTの本文など
条件に当たるページの応答を受け取る
応答を受け取った相手と、検索エンジンのキャッシュ
LeftoverLocals(CVE-2023-4969)
2024年1月
GPUのローカルメモリに残ったLLMの応答など
同じGPUで攻撃者がプログラムを動かす
攻撃者
Workers AIのGLM 5.3
2026年10月
他社のプロンプトと生成途中の文
681,280トークンより長いプロンプトを送る
送った顧客の応答
気がかりなのは一番下の行です。LeftoverLocalsと違い、読むのに攻撃のコードは要りません。ふつうのAPIの呼び出しに、他社のデータがHTTP 200の応答として返りました。しかもCloudflareによると、応答は筋の通った文でした。Cloudflareは意図的な悪用の証拠は見つかっていないと説明していますが、悪用がなくても他社のデータは届いたことになります。
2017年のCloudflareは、検索エンジンと協力してキャッシュを消しました。今回はその相手がいません。出た先は受け取った顧客のシステムで、消せるのは受け取った本人だけです。
ログやベクトルデータベースに残っているかもしれませんし、AIエージェントならその内容をもとに次の処理へ進んだこともありえます。
通知の条件は、契約の種類で違う
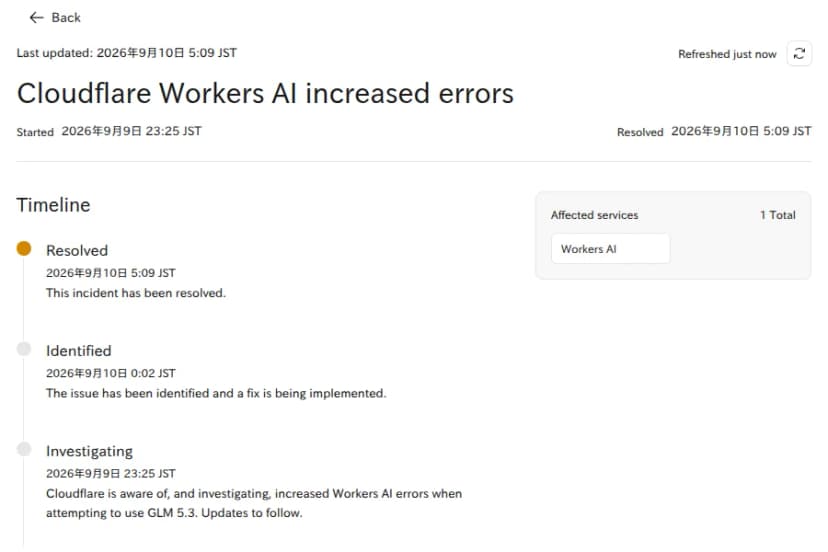
状況ページを見ていても、混入には気づけませんでした。9月9日の題は「Cloudflare Workers AI increased errors」で、本文もGLM 5.3のエラーの増加です。
9月9日の状況ページ。題はエラーの増加で、データの混入には触れていない 出典: Cloudflare Status「Cloudflare Workers AI increased errors」 (引用) データの混入を説明した投稿は10月26日で、編集部で数えると解消から47日あとでした。修正版が出そろう前に細部を出せば、ほかの運用者が狙われかねないので、この間を責めるつもりはありません。状況ページの読み方 で書いたとおり、このページで分かるのは主に止まっているかどうかです。
では、影響を受けた顧客に個別の連絡は届く契約なのか。Cloudflareの公開の契約文書を読むと、契約の種類で書き方が違います。
文書
通知の定め
対象のデータ
企業向け契約に組み込まれるInformation Security Exhibit
通知し、調査して、報告を出す
Customer Data(Customer Contentを含む)
セルフサーブ契約の本文
読んだ範囲では見つからない
なし
データ処理の付属文書(DPA)
通知して協力する
個人データ
通知の定めがある2つの文書とも、期限は「without undue delay」で、時間の数字はありません。
プロンプトがCustomer Contentに当たることは、データの扱いのページに書かれています。企業向け契約なら、個人データのない社外秘の文書でも通知の対象と読めます。一方、セルフサーブ契約の本文には通知の定めが見当たらないので、個人データのない社外秘については、通知を受ける根拠をこの本文からは読み取れません。
日本の個人情報は別の話です。DPAの定義は適用される法令を広く含みますが、セルフサーブの本文はDPAの対象をEUや英国、カリフォルニア州の法律の個人データとして書いていて、読み方が分かれそうです。
部署がオンラインで申し込んだAPIが、そのまま本番に入っている会社は要注意です。個別に結んだ契約があれば、内容は変わります。
保存しないサービスほど、調べる材料は自社に残す
ゼロデータリテンションには裏返しがあります。Cloudflareが残すと書いている情報は、アカウントとモデルの識別子、時刻、リクエストと応答のサイズ、トークン数などのメタデータで、顧客のコンテンツは含みません。事故のあとで「何が出たか」をたどる記録は、事業者の側にはほとんど残らないはずです。
手元に材料を持てるかは、自社のログ次第です。AI Gatewayを使っていれば、ログにプロンプトや応答、トークン数を残せます。ログはゲートウェイごとに既定で有効で、本文を残さずメタデータだけにするヘッダーもあります。
本文を残せば、そのログが機微な情報の新しい保存先になります。悩ましい判断ですが、モデルと時刻、トークン数だけでも残っていれば、今回の「受け取った側か」には答えられます。
公表からは分からないこと
影響を受けた顧客や出どころの顧客に、個別の連絡があったか。
出どころになった顧客の数と、155件全体の中身。
Cloudflareが今回を、契約上の通知の対象と判断したか。
データの扱いのページの事故当時の文面。今のページの更新日は10月16日です。
Workers AIでGLM 5.3を使っていた会社の手順
Cloudflareの推奨はSGLangの運用者向けで、Workers AIの利用者向けの手順は投稿にありません。次は公開の資料から組み立てた順番です。
自社のコードと設定で@cf/zai-org/glm-5.3の利用を探し、開発担当者に8月27日から9月9日23時(日本時間)までの利用を確認します。OpenRouterのように提供元を振り分けるサービス経由で呼んでいた場合も、提供元がCloudflareだった可能性があります。研究者が最初に異変を見たのもこの経路でした。利用履歴に提供元が残っていれば確認します。
AI Gatewayかアプリのログが残っていれば、モデルと時刻で絞り、プロンプトのトークン数が681,280を超える行を探します。長いのに速く返った行も手がかりで、研究者の実測では662,162トークンに68.9秒かかったのに、700,168トークンは7.1秒で返りました。
該当する行があれば、その応答の保存先を洗い出します。他社のものらしい内容が見つかったときは、広げずに隔離し、法務とCloudflareのサポートに連絡してください。
利用が確認できたら、長さにかかわらず、送っていたデータの種類を担当者に聞きます。個人データや社外秘があれば法務に共有し、自社のアカウントが出どころか受け取り手に当たるかをCloudflareに問い合わせます。答えが出るとは限りませんが、問い合わせた記録は残るはずです。
自社でSGLangを動かしている会社は、1週間以内にv0.5.22以降へ更新します。2
両者の投稿にCVE番号は見当たらず、SGLangのGitHubの勧告のページも10月31日の時点で空でした。脆弱性スキャナーでは拾えないかもしれないので、版は台帳で確認したいところです。
AIのAPIの事業者に確認すること
それ以外の会社は急ぎません。次の契約更新か委託先の確認の時期に、次の5つを聞いておくと、あとの判断が楽になります。
項目
そのまま送れる質問
答えの見方
GPUメモリの分離
リクエストの間でGPUメモリを他の顧客と共有していますか。再利用の前に消去するか、持ち主を検証していますか
「組織単位で分離」だけなら、キャッシュ機能の答えかもしれない。聞き直す
推論エンジンと修正
推論エンジンに何を使っていますか。SGLangでprefillとdecodeを分けているなら、版はv0.5.22以降ですか(NIXLかMORIならv0.5.23以降)
名前が非公開でも、修正をどう追っているかは聞ける
事故の通知
個人データを含まないプロンプトが他社の応答に出た場合も、個別に通知しますか。期限は何時間ですか
どの文書のどの条項かを、文面で受け取る
事故のときの記録
保存しない場合、事故のときに何が残りますか。自社のデータが対象かを照会できますか
メタデータの項目と保持期間まで聞く
専有の選択肢
他の顧客とGPUを共有しない契約はありますか
費用と合わせて、扱う情報の区分で判断する
GPUの内部は公開していない事業者も多く、答えが返らないこともありそうです。返らなかったこと自体を台帳に残しておけば、次の節の条件を厳しくする材料になります。委託先のセキュリティ確認シートなら、質問18(生成AI)と質問21(知らせる窓口と期限)の下に足せます。
社内で決めておく入力の条件
事業者の答えが出そろわなくても、社内で決められることはあります。
情報区分に「他社の応答に出ても耐えられるか」の軸を足す。緑は出ても困らないもの、黄は通知の条件を確認したサービスだけ、赤は外部のAPIに入れないもの、のように書きます。
長いコンテキストをまとめて渡す条件を決める。SGLangの開発元によると、長いコンテキストほど競合状態は起きやすくなります。リポジトリやファイルサーバーを丸ごと渡す使い方から見直すとよいでしょう。
ログの方針を決める。モデルと時刻、トークン数は必ず残し、本文を残すかは情報区分で分けます。
APIの申し込みを部署任せにしない。どの契約で使っているかを台帳に書きます。
緑・黄・赤の区分は、生成AI利用ガイドラインの別表2にそのまま足せます。
見覚えのない文が返ってきたら
AIの応答に、知らない社名や別のプログラムのコードが混ざっていた。これまでならハルシネーションとして流していた場面でしょう。
SGLangには7月6日に、同じ不具合が別の利用者から報告されていました。Issueの言葉は、入力と関係のない「garbage」の出力です。Issueには修正案が付き、7月8日には修正のプルリクエストも出ましたが、取り込まれないまま、Issueは9月5日に自動で閉じられました。研究者の報告が届く3日前のことです。出力がおかしいという報告だけでは、情報の混入とは読めなかったのでしょう。
研究者が投稿の題に選んだ言葉も「Hallucination or Cross-Tenant」で、投稿の大半は、ハルシネーションや学習データの再現ではないと確かめる手順です。
社内ルールに一行足すなら、ここです。見覚えのない固有名詞や他社のものらしい内容が出たら、社内チャットに貼らず、モデル名と時刻を控えて情シスに知らせる。ハルシネーションかどうかを、利用者に判断させないことです。
「学習に使わない」を確認したあとに決めるのは、案外この一行なのかもしれません。