「AIボットは通す」と決めたWAF のルール、条件はUser-Agent(UA)だけになっていませんか。そうなら、1週間以内に直しておきたいところです。Cequenceは10月28日、約32のAIボットになりすまし て.envやクラウド の認証情報 、SSH の秘密鍵を探すスキャンを追跡していると報告しました。
もっとも、AIボットをすべて止める話ではありません。今日いちばん先に調べるのは、公開領域に認証情報のファイルが置かれていないかです。
追跡されたのは約32の名前を使う相手
Cequenceの調査チームは、このスキャンを1つの攻撃者によるものとみています。大手クラウドから届き、OpenAI、Anthropic、Meta、Perplexityなどのクローラーやアシスタントの名前を順に使います。Webページには見向きもせず、約90のパスから、秘密の値が入っていそうなファイルだけを要求するのが特徴です。
1つのIPアドレスが約8秒で50〜190件を送ると、次へ移ります。標的を1つずつ昼夜を問わず回り、少なくとも9月下旬から10月下旬まで続きました。届いた先は金融、小売、通信、エネルギー、ソフトウェアの組織です。
偽物と分かった理由は、かなり素朴でした。同じマシンが数秒のうちにOpenAIにもAnthropicにも、MetaにもPerplexityにもなります。32の名前を均等に回す動きも、実在のボットにはありません。Claudeを名乗る要求に至っては、ClaudeBot以外を装うときもAnthropicのクローラーの連絡先が付いたままでした。Cequenceによると、文字列をコピーして貼った跡です。
名前はAIでも、AIを使った攻撃だと分かったわけではありません。NorForgeが調べた攻撃者の管理画面 はAIで攻撃を進めるツールの話でしたが、今回の報告で読み取れるのは、信用されやすい名前を借りていることまでです。
48%は侵入された割合ではない
目を引く48%は、10月のある1日に、Cequenceの保護先のうちAIボットの通信があった組織の48%へ、このスキャンが届いたという数字です。分母の組織数は示されていません。そのうえ要求のほぼすべてが、遮断か失敗に終わりました。
つまり、ノックされた割合であって、ファイルを取られた割合ではないのです。
かといって、安心材料として読むのも早いでしょう。遮断と失敗の内訳は公表されておらず、ボット対策を導入している組織での結果なので、対策のないサイトで同じになるとは言えないからです。
情シスの外に関わる数字もあります。複数の組織で、AIボットと表示された通信の80%超をこのスキャンが占めていました。「AIボットのアクセスが増えた」という社内の報告も、UAで数えているなら割り引いて読む必要があります。AI検索への対応を進める広報やマーケティングの担当者には、早めに伝えておきたい話です。
3社の観測は同じ攻撃とは言い切れない
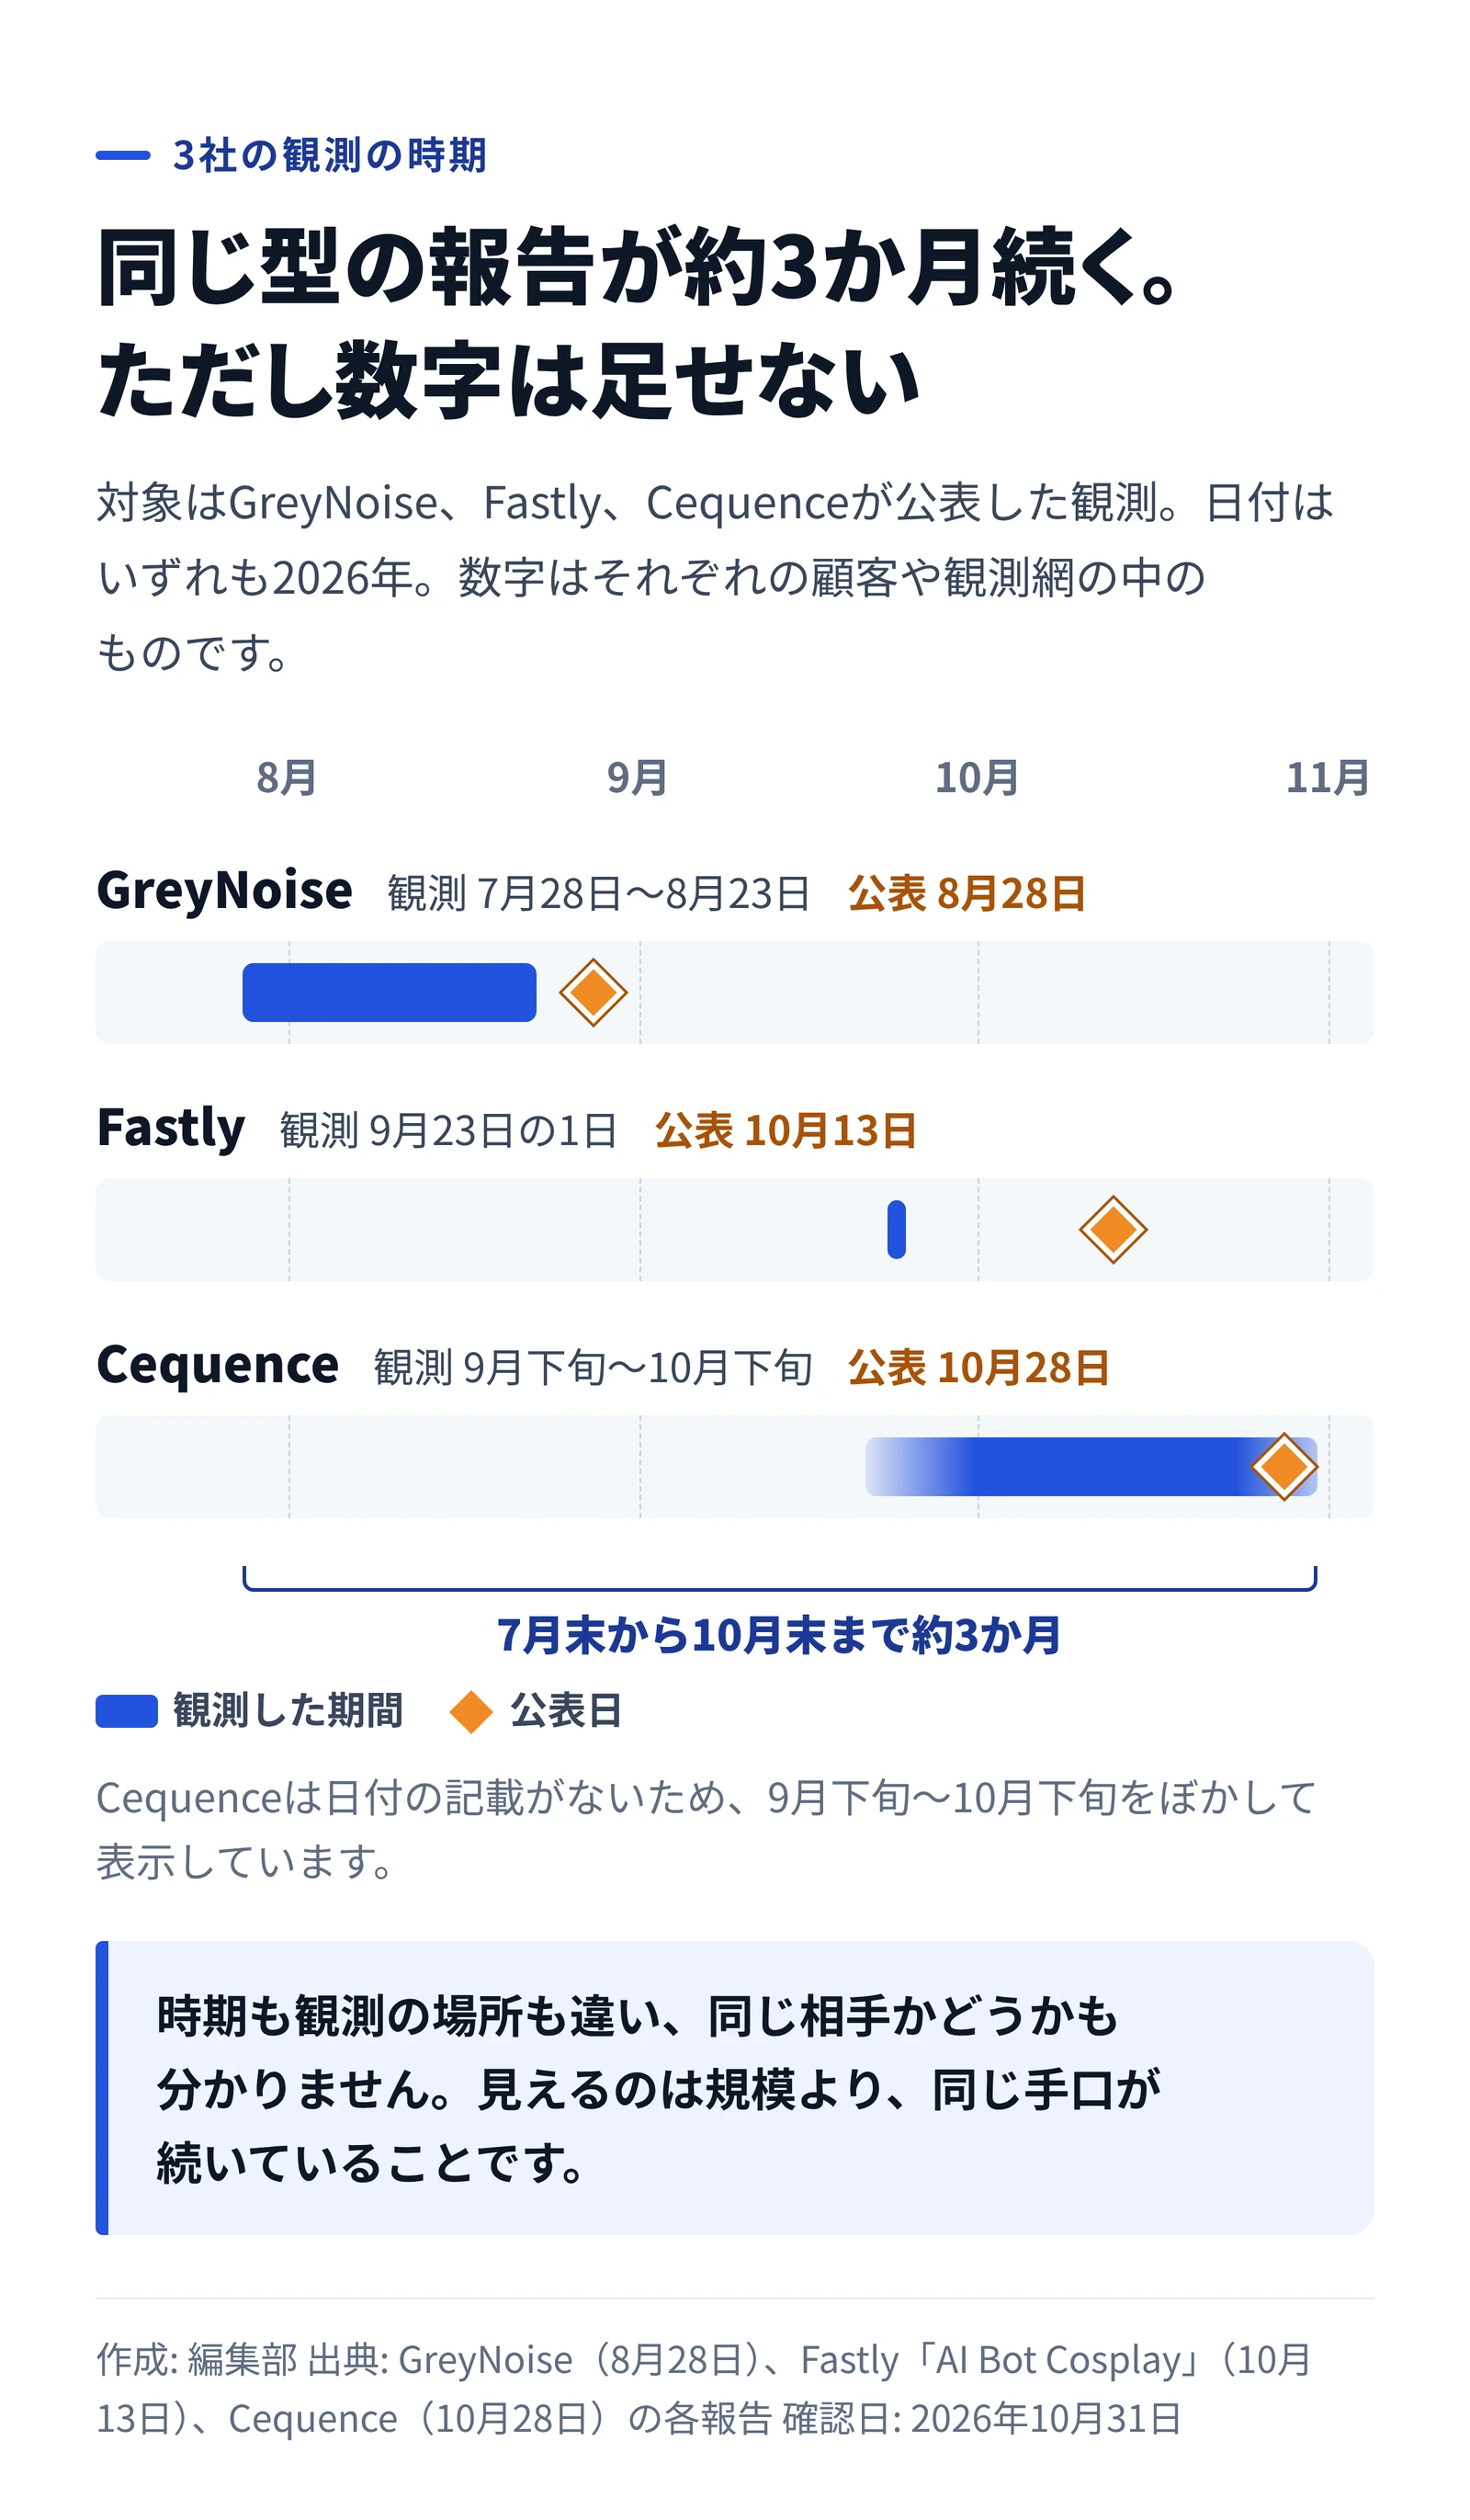
同じ型の報告は、夏にも出ていました。GreyNoiseが8月28日に、Fastlyが10月13日に、それぞれの観測を公表しています。Cequenceを加えた3社の時期を図に、数字を表にまとめました。
3社の観測と公表の時期。同じ型の報告が約3か月続くが、数字は足せない 作成: 編集部 / 出典: GreyNoise、Fastly、Cequenceの報告をもとに編集部が作成
項目
GreyNoise
Fastly
Cequence
観測した期間
7月28日〜8月23日
9月23日の1日
9月下旬〜10月下旬
観測した場所
自社の観測網
Next-Gen WAFとBot Managementの利用者
自社の保護先
使われた名前
13(うち6つが同じ824アドレスから)
主な攻撃で12
約32
IPアドレス
824(795の/24に分散)
約10,200(うち約1,600で94%)
1日に300超、1週間で400弱
探したパス
上位10件を公開
96のファイル名
約90
要求の規模
同じフィンガープリントの通信で数百万件
1日に約630万件、主な攻撃で10万超のサイト
1アドレスで約8秒に50〜190件
ファイルが取られたか
分からないと明記
記述なし
ほぼすべて遮断か失敗
3社に共通するのは、AIの名前をいくつも借りて、.envなどの認証情報のファイルを探す動きです。一方で、名前の数もIPの数もそろいません。3社ともボット対策や脅威情報を提供する会社で、数字はそれぞれの顧客や観測網の中のものです。
同じ相手かどうかはどの報告からも分からず、観測の日数も違うので、数字は足さないほうが安全です。ファイルを取られた会社の例も、3社とも挙げていません。
言えるのは規模よりも、手口の定着でしょう。7月末から10月末までの約3か月に、別々の観測網で同じ型の動きが報告されました。
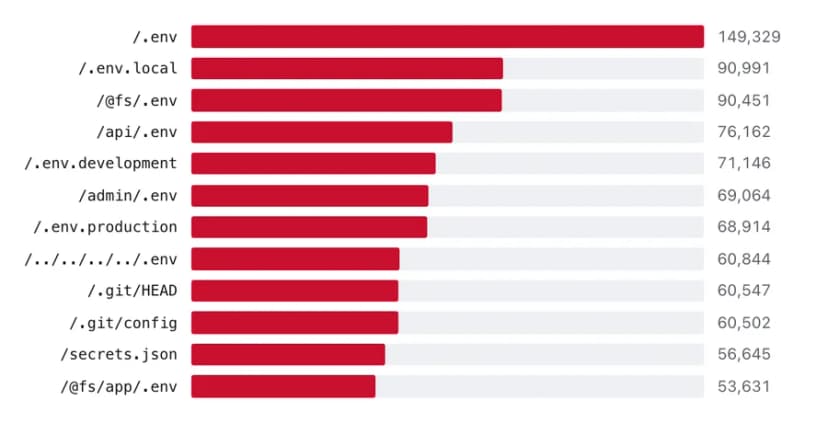
狙う先はかなり絞られています。Fastlyの1日の集計では、.env系が約400万件で、全体の約630万件の6割強を占めました(割合は編集部で計算)。
Fastlyが公開した、偽のAIボットが1日に狙ったパスの上位。/.envが最多 出典: Fastly「AI Bot Cosplay」 (引用) 上位に入った/@fs/.envは、Fastlyによると、Viteの開発サーバーのファイル用ルートを狙うパスです。Vitestの開発サーバーから.envが読める脆弱性 もそうでしたが、開発用のサーバーは本番の点検から漏れやすいところ。検証環境や開発サーバーが外から届くなら、そちらも同じように調べます。Viteを使っているなら、GreyNoiseは修正版への更新も勧めています。1
robots.txtの許可は穴にならない
AI検索に載せたいとき、設定する場所は2つあります。混同すると、直す場所を間違えます。
1つ目のrobots.txtは、クローラーへのお願いにすぎません。規格のRFC 9309も、アクセスの認可ではないと明記しています。
These rules are not a form of access authorization.
出典: RFC 9309 Robots Exclusion Protocol
GreyNoiseの観測でも、偽物の6つの名前はrobots.txtを一度も読みませんでした。Allowを書いても穴は増えないわけです。逆にDisallow: /.envと書くと、RFC 9309が注意するとおり、ファイルの場所を自分で公開することになります。
2つ目が、WAFやCDNの除外、レート制限の例外です。こちらは通信の扱いが本当に変わります。Fastlyは、攻撃者がAIボットの名前を借りる理由として、許可リストに入れたりレート制限を緩めたりするサイトがあることを挙げました。Cequenceも、どのエージェントが信頼されているかを試す動きを見ていると書きました。32の名前を均等に回すのは、どの名前なら通るかを総当たりで試しているようにも見えます。
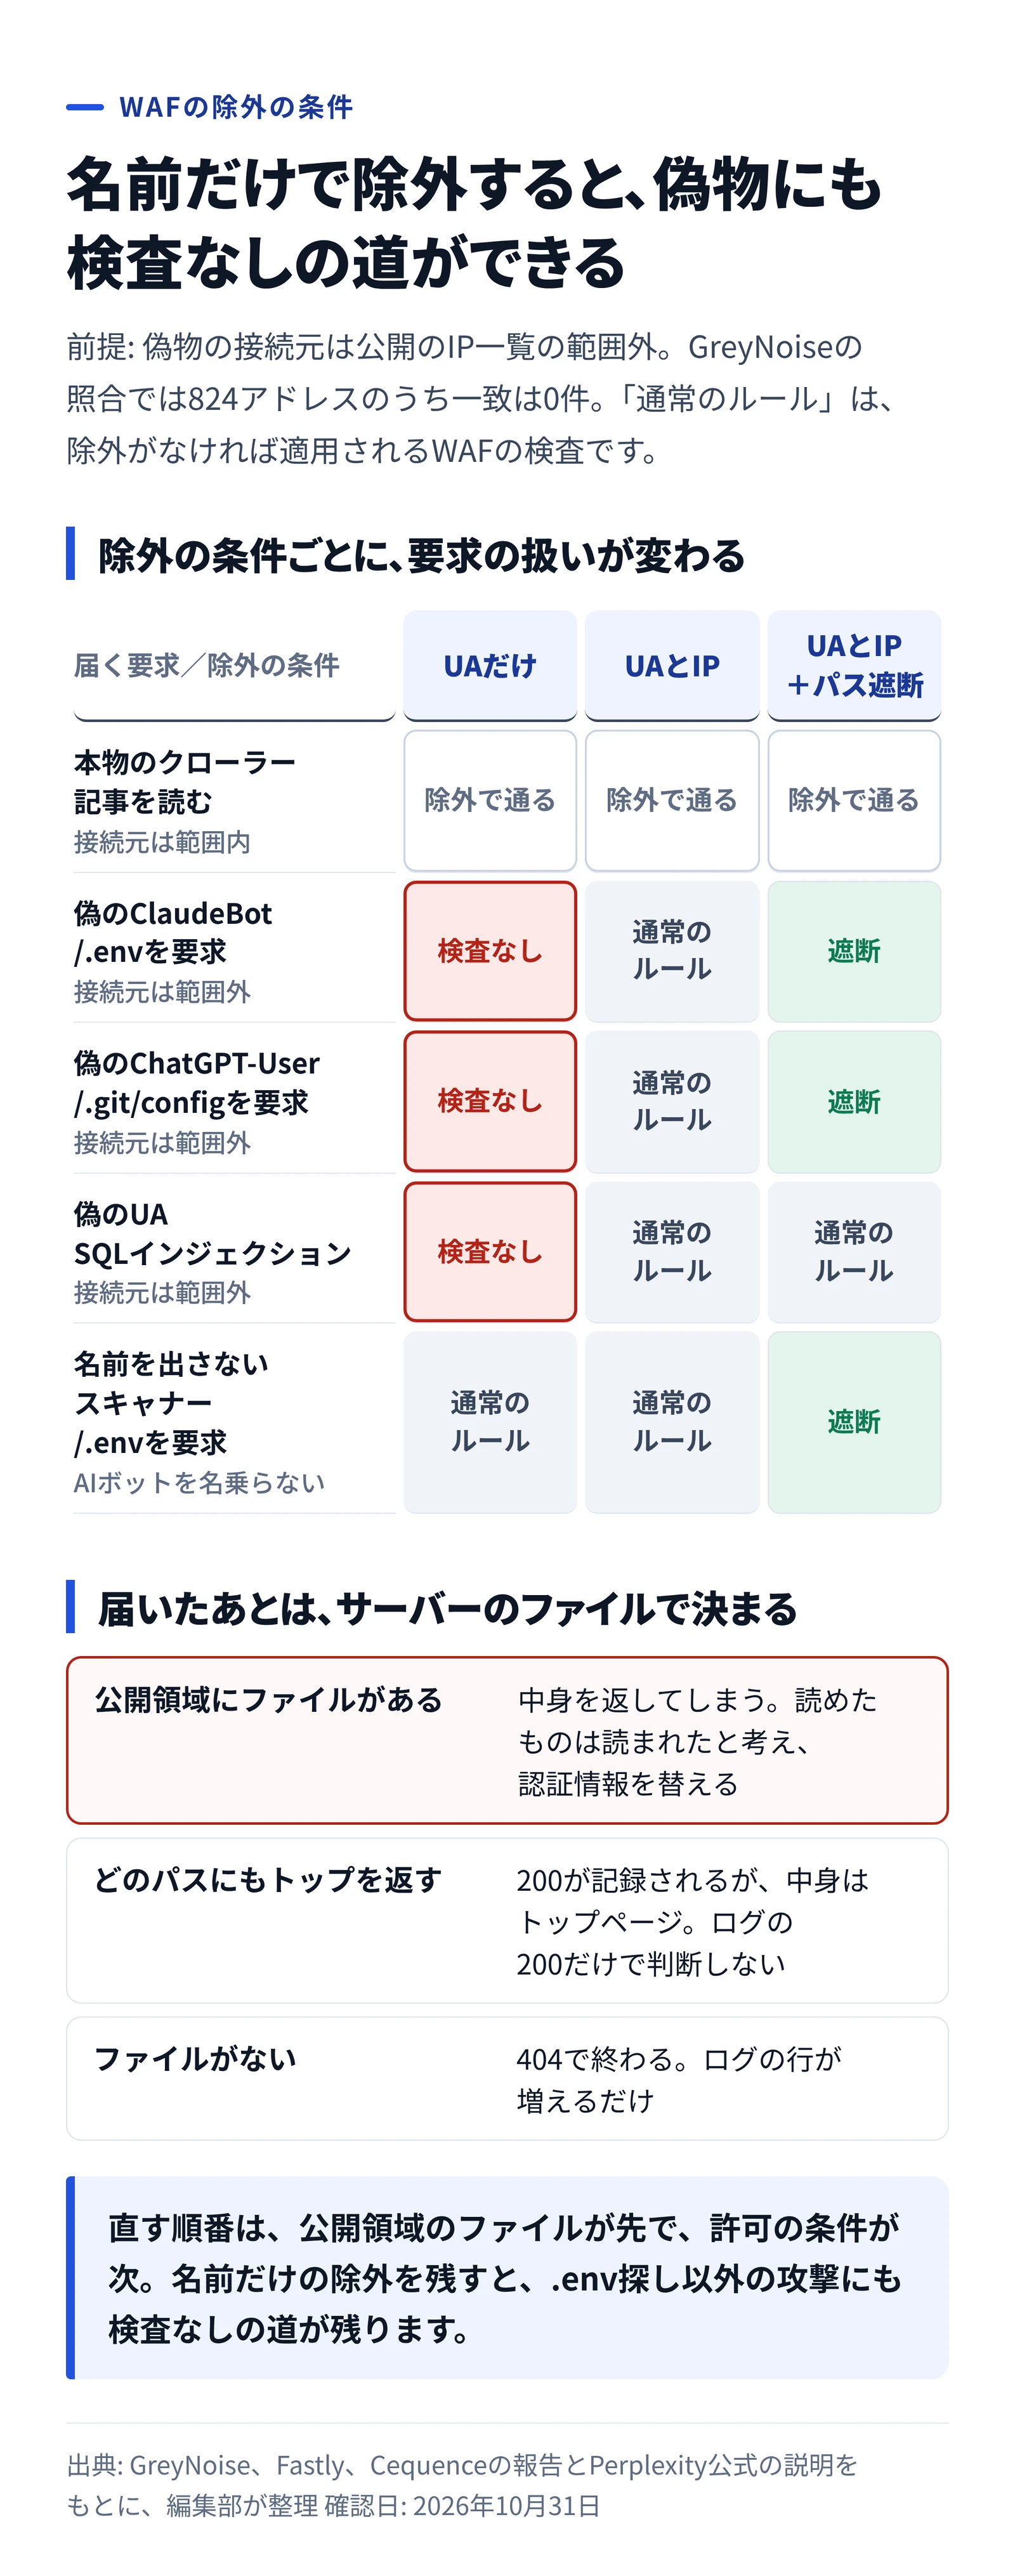
影響が大きいのは、検査ごと飛ばす設定でしょう。Perplexityの説明にあるCloudflareの設定例では、条件に合う要求についてマネージドルールやレート制限をスキップできます。同社の例はUAとIPの両方が条件です。これがUAだけなら、UAを書き換えた要求は、中身を問わず検査なしで届きます。.env探しに限らず、SQLインジェクションでも同じです。
除外の条件ごとに、届く要求の扱いがどう変わるかをまとめた表 作成: 編集部 / 出典: GreyNoise、Fastly、Cequenceの報告とPerplexityの説明をもとに編集部が作成 広報やマーケティングの依頼で急いで足した例外は、見直しから漏れやすいと編集部は考えます。セキュリティの確認より、検索に載ることを目的に足した設定だからです。CloudflareとOpenAIの検索の試験 の記事でも触れたとおり、検索で見つけてもらうことと、通信を許可することは別の話です。
本物かどうかは接続元で決める
UAは自己申告で、決め手になるのは接続元のIPアドレスです。GreyNoiseが824のアドレスを各社の公開の一覧とすべて照らしたところ、1件も一致しませんでした。主な会社の公開の状況を、10月31日に確認しました。
まず、一覧は動きます。ファイルの作成日時を見ると、ChatGPT-Userは10月27日、Perplexityの2つは10月28日、Anthropicは10月20日でした。OAI-SearchBotのように1月2日のままのものもあり、日時が新しくても中身が変わったとは限りません。それでも、WAFに手で貼ったままだと、いずれ本物を止めかねないでしょう。Perplexityの説明にも、定期的に取り直す自動化を組むようにとあります。
「robots.txtを読まないから偽物」と決めつけるのも危険です。GreyNoiseは手がかりに挙げていますが、表のとおり、利用者の操作で動くボットはrobots.txtに従うとは限りません。使えるのはクローラーの判定までと考えたほうがよいでしょう。
一方、Google-Extendedは迷わずに済みます。Googleの説明ではHTTPのUAとして送られない名前なので、ログにあれば偽物です。GreyNoiseの観測では263,849セッションがこの名前を使っていました。
Metaは少し事情が違います。説明のページはFacebookExternalHitについて、許可リストにUAかIPを入れるよう案内し、IPのほうが安全だと注記するものの、同じページにIPの一覧は載っていません。
照らすIPにも落とし穴があります。X-Forwarded-Forから取ったアドレスで判定すると、送り手が書き換えられてしまいます。RemoteAddrとSocketAddrの違いとして、Azure Front DoorのWAFの記事 で取り上げたのと同じ話です。名前をIPに変えても、そのIPが自己申告なら穴は残ります。
一覧を自分で持たない方法もあります。Cloudflareのcf.client.bot、AWS WAF Bot Controlのbot:verified、FastlyのVERIFIED-BOTは、製品側で確認した結果を条件に使えます。どのボットが対象かは製品ごとに違うので、通したい名前が入っているかを先に見ておきます。署名で確かめるWeb Bot Authも、Cloudflareは確認方法に入れていますが、土台はまだIETFのドラフトです。
影響するのはUAで通している会社
急ぐかどうかは、AIボットを許可しているかではなく、どこで何を条件に許可しているかで分かれます。
自社の状態
何が起きるか
動く時期
公開領域に.envや秘密鍵がある
名前に関係なく、届いた要求に返してしまう
今日
WAFやCDNの除外、レート制限の例外がUAだけ
UAを書き換えた要求が検査なしで届く
1週間以内
AIボットの件数をUAで集計している
報告の数字が膨らむ
次の報告まで
robots.txtで許可しているだけ
影響しない。穴は増えない
ログの確認だけ
UAとIP、または確認済みボットの判定で許可
名前を偽っても除外に当たらない
一覧の更新を確認
自社でWebサーバーを持たない
直接は影響しない
制作会社に手順1を依頼
見直しの本命は2行目です。AI検索を意識して設定を変えた会社は、ここに入りやすいはずです。
今日のうちに確認する手順
コマンドはnginxとcombined形式のログの例で、Apacheならパスを読み替えます。外から自社の/.envを開いて試すのではなく、すべてサーバーの中で調べてください。
公開領域にファイルがないかを検索します。ドキュメントルートはWebサーバーの設定で確認し、検証環境と開発サーバーも含めます。出るのはファイル名と更新日だけで、中身は開きません。
nginx -T 2>/dev/null | grep -E '^\s*(root|alias)\s'
find /var/www/example/public \( -name '.env' -o -name '.env.*' -o -name '.git' -o -name '.git-credentials' \
  -o -name '.aws' -o -name '.ssh' -o -name 'id_rsa*' -o -name 'id_ed25519*' -o -name 'id_ecdsa*' \
  -o -name '*.pem' -o -name '*.key' -o -name 'secrets.json' -o -name 'credentials' \
  -o -name '*.sql' -o -name '*.sql.gz' \) -not -path '*/node_modules/*' \
  -printf '%TY-%Tm-%Td %p\n' | sort
ログから秘密のパスへの要求を抜き出します。約32の名前は全部が公開されているわけではないので、まずUAを絞らずに数を見ます。
zgrep -hE '"[A-Z]+ [^"]*(\.env|\.git/|\.aws/|\.ssh/|id_rsa|id_ed25519|id_ecdsa|secrets\.json)' \
  /var/log/nginx/access.log* > secret-paths.log
awk -F'"' '{print $6}' secret-paths.log | sort | uniq -c | sort -rn | head -30
応答を見ます。curlなど名前を出さない要求や、一覧にない名前の要求で取られた場合を見落とさないよう、まず名前で絞らずに200と206を確認し、そのあとでAIボットの名前に絞ります。200があっても、すぐに漏えいとは限りません。どのパスにもトップページを返すサイトでは、/.envにも200が並ぶからです。Cequenceによると、スキャナーも無意味なパスを先に送り、そうしたサイトを見分けています。サイズがトップページと同じならその可能性が高く、違うサイズなら手順1の結果と突き合わせます。
awk '$9 ~ /^(200|206)$/ {print $1, $7, $9, $10}' secret-paths.log | sort -u
grep -iE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Perplexity-User|meta-external|meta-webindexer|facebookexternalhit|Google-Extended|Amazonbot|CCBot|DuckDuck|DuckAssist' \
  secret-paths.log > ai-named.log
awk '{print $9, $10}' ai-named.log | sort | uniq -c | sort -rn
公開の一覧と照らします。上の表のJSONを同じフォルダーに保存し、次のスクリプトをcheck_ai_bots.pyとして保存し、python3 check_ai_bots.py ai-named.log | sort | uniq -c | sort -rnで実行します。CDNやロードバランサーの内側では先頭が中継のIPになることがあるので、接続元のIPが先頭に来るログで動かしてください。秘密のパスに来た「範囲外」は、偽物とみてかまいません。「範囲内」なら、自社のページからリンクしていないかを見ます。Metaなど、スクリプトの対象にしていない名前は「一覧なし」と出ます。
import ipaddress, json, sys
LISTS = {
    "GPTBot": "gptbot.json", "OAI-SearchBot": "searchbot.json", "ChatGPT-User": "chatgpt-user.json",
    "ClaudeBot": "bots.json", "Claude-User": "bots.json", "Claude-SearchBot": "bots.json",
    "PerplexityBot": "perplexitybot.json", "Perplexity-User": "perplexity-user.json",
}
nets = {}
for name, path in LISTS.items():
    prefixes = json.load(open(path))["prefixes"]
    nets[name] = [ipaddress.ip_network(p.get("ipv4Prefix") or p["ipv6Prefix"]) for p in prefixes]
for line in open(sys.argv[1], errors="ignore"):
    ip = ipaddress.ip_address(line.split()[0])
    ua = line.rsplit('"', 2)[-2].lower()
    if "google-extended" in ua:
        print("偽物", ip, "Google-Extended")
        continue
    for name, networks in nets.items():
        if name.lower() in ua:
            print("範囲内" if any(ip in n for n in networks) else "範囲外", ip, name)
            break
    else:
        print("一覧なし", ip, ua[:60])
許可の条件を直し、秘密のパスを止めます。Webサーバーの設定とWAFのルールから、UAを条件にしている所を探します。Cloudflareの式なら、Perplexityの例のようにUAとIPの両方を条件にします。
grep -RniE 'gptbot|claudebot|chatgpt-user|perplexity|http_user_agent|SetEnvIf.*User-Agent' /etc/nginx /etc/apache2 2>/dev/null
(http.user_agent contains "PerplexityBot" and ip.src in {<PerplexityBotのIP範囲>})
点で始まるパスは、名前を見ずに止めて構いません。.well-knownは証明書の更新などに使うので除きます。nginxは正規表現のlocationを書いた順に評価するので、ほかの正規表現より前に置きます。
location ~ /\.(?!well-known/) { return 404; }
この1行で止まるのは、点で始まるパスだけです。/secrets.jsonや/backup/id_ed25519、.sqlのファイルは止まらないので、手順1で見つけたら公開領域から外します。^~を付けたlocationに合うパスも、正規表現より優先されて素通りします。反映の前にnginx -tで構文を確認してください。
GreyNoiseが勧めるとおり、/.envや/.aws/credentials、/.git/configへの要求には通知も付けておきます。攻撃元IPの遮断リストに時間をかける必要はありません。Cequenceの観測では、9月下旬のアドレスは1か月後に1つも現れませんでした。
見つかったら外から使える認証情報を先に替える
GreyNoiseの助言は明快です。Webのパスから届いたことのあるクラウドのキーは替える。読めたものは読まれたと考える。ログに200が残っていなくても、無事の証明にはなりません。保存期間より前のことは分からないからです。
替える順番は報告にないので、編集部で組みました。基準は、盗まれたらそれだけですぐ使えるかどうかです。
Web、WAF、CDNのログを別の場所へ控えます。ローテーションで消える前に済ませます。
ファイルを公開領域の外へ移します。すぐに移せないなら、先にWebサーバーの設定でそのパスを404で止めます。次のコマンドで変数名だけを控えれば、値を画面に出さずに替える対象を洗い出せます。小文字の変数名は出ないので、ある場合は別に確認します。.gitが見つかったときは、履歴に残った古い値も対象です。
grep -oE '^[[:space:]]*(export[[:space:]]+)?[A-Z_][A-Z0-9_]*=' .env | sed 's/=$//'
クラウドのキーとSSHの秘密鍵を替えます。AWSの手順は、2本目のキーを作ってアプリを更新し、古いキーを無効化して、時間をおいて削除する順です。ただ、読まれた形跡があるなら、アプリが止まるのを覚悟して無効化を先にします。SSHは、対応する公開鍵を踏み台を含む全サーバーのauthorized_keysから外します。
データベースのパスワードと、決済やメール配信、AIなどのAPIキーを替えます。
セッションの署名に使う秘密の値は最後に替えます。サービスによっては利用者が一斉にログアウトするので、案内を用意してから進めます。
使われた形跡を調べます。AWSのlookup-eventsで引けるのは、今のリージョンの管理イベントを過去90日分までです。そのためリージョンを順に回します。次のコマンドはAWSの説明をもとに組んだもので、実行での確認はしていません。顧客データのあるデータベースに届く認証情報なら、法務にも早めに声をかけます。
for r in $(aws ec2 describe-regions --query 'Regions[].RegionName' --output text); do
  aws cloudtrail lookup-events --region "$r" --lookup-attributes AttributeKey=AccessKeyId,AttributeValue=<古いキーのID>
done
AI検索に載せたいという相談は、これからも増えるでしょう。そのとき情シスから返す質問は、どのボットを通すかのほかにもう1つあります。「そのボットが本物だと、何で判断しますか」。