ほとんどの会社には影響がありません。対象は、CloudflareのAIの実行基盤「Workers AI」で、GLM-5.3というモデルに、68万トークンを超える長い依頼を送っていた一部の顧客だけです。
ただ、起きたことは重い部類に入ります。8月27日から9月9日まで、そのモデルへの応答155件に、ほかの顧客が直前に送った依頼の中身が混ざっていました。Cloudflareが10月26日に経緯を公表しています。
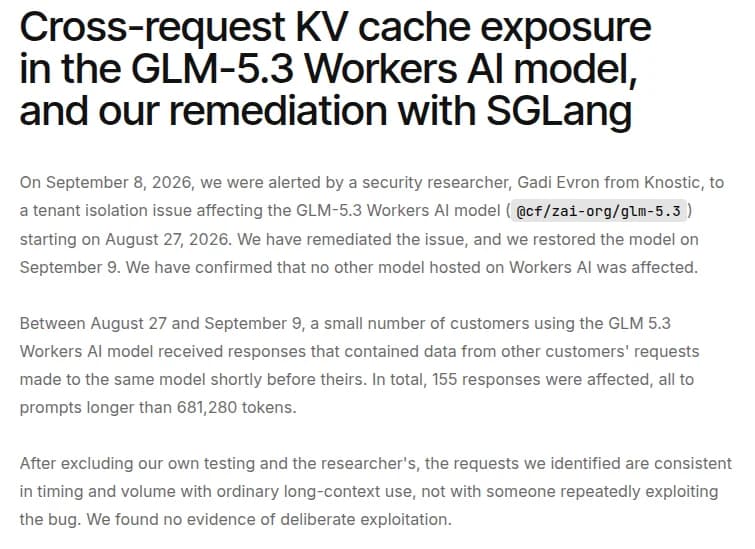 Cloudflareの公表。155件の応答に、他社の依頼の中身が混ざった出典: Cloudflare「Cross-request KV cache exposure in the GLM-5.3 Workers AI model, and our remediation with SGLang」(引用)
他社の依頼の中身が、応答に混ざった
報告したのは、セキュリティ研究者のGadi Evron氏(Knostic)です。Cloudflareのバグ報奨金の窓口に、9月8日に届きました。Cloudflareは9日に再現を確かめてモデルを止め、同じ日のうちに直して公開を戻しています。
| 日付(協定世界時) |
できごと |
| 8月27日 |
GLM-5.3をWorkers AIで公開。この時点で問題があった |
| 9月8日 |
研究者からの報告を受ける |
| 9月9日 |
2つのアカウントで漏れを再現し、モデルを非公開に。設定と推論エンジンを直して公開を戻す |
| 9月16日〜10月12日 |
推論エンジンSGLangの側でも修正が取り込まれる |
| 10月19日 |
SGLang 0.5.22が出る |
| 10月26日 |
研究者、SGLangの開発元と合わせて公表 |
混ざったのは、同じモデルに少し前に送られた他社の依頼と、生成の途中の文です。Cloudflareは、自社と研究者の試験を除くと、該当する依頼はふつうの長い文書を扱う使い方と時期も量も合っていて、だれかが繰り返し悪用した様子は無いとしています。ほかのWorkers AIのモデルは影響を受けていないと確認しています。
GPUのメモリーを、顧客どうしで使い回していた
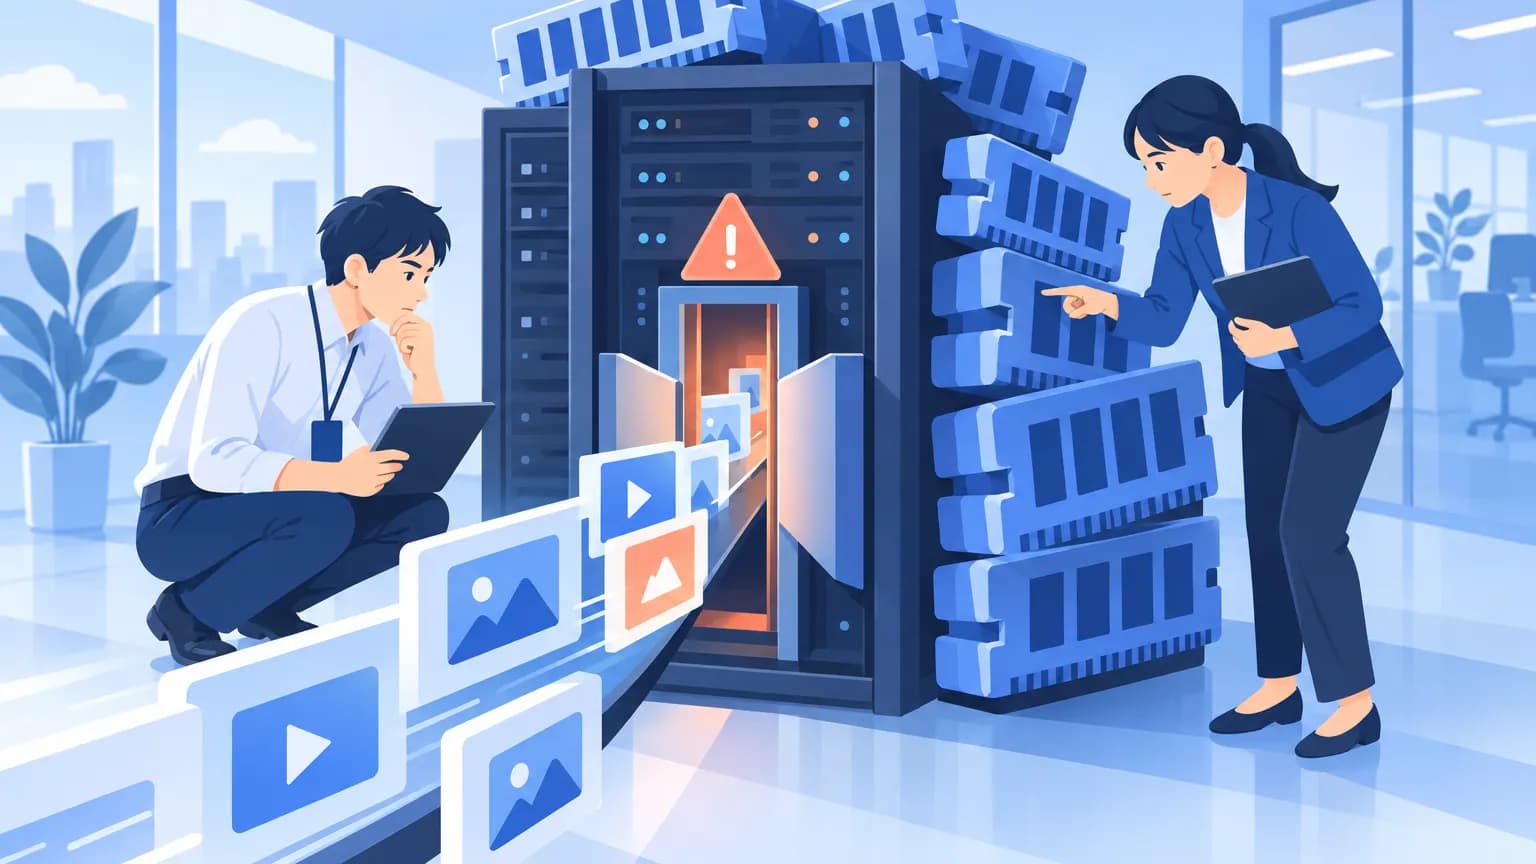
生成AIは、依頼の文を読むときの途中の計算を、GPUのメモリー(KVキャッシュ)に置きます。このメモリーは決まった大きさのページに分けられ、依頼が来るたびに貸し出され、終われば返されます。返されたページは消されず、次の依頼が上から書きます。速さを出すためで、推論エンジンではよくある作りだそうです。
そこに2つの問題が重なりました。1つは設定です。GLM-5.3は約105万トークンまで受け付ける設定でしたが、GPUに用意したページは約68万トークン分しかありませんでした。もう1つはSGLangの不具合です。ページに入りきらない依頼をエラーで返さず、1トークンだけの依頼に置き換えて処理を続けていました。
その結果、応答を作る側は、書き込まれていないページまで読みました。そこに残っていたのが、前の依頼の中身です。利用者には、エラーではなく正常な応答(HTTP 200)として返っていました。
Cloudflareは、事前の試験で、長い依頼への応答コードと速さだけを見て、応答の中身が正しいかを確かめていなかったと認めています。
うちの会社に関係あるか
関係があるのは、次の2つの場合です。
- Workers AIで、8月27日から9月9日のあいだにGLM-5.3を使っていた会社。とくに、68万トークンを超える長い文書をまとめて渡していた場合
- 推論エンジンのSGLangを、自社のGPUサーバーで、prefillとdecodeを分ける形(分離構成)で動かしている会社
Workers AIのほかのモデルや、Cloudflareのほかのサービスだけを使っている会社は対象外です。GLM-5.3というモデル自体の性能や提供の状況は、Amazon、BedrockでZ.aiのGLM 5.3を提供(YOBITSUGI AIメディア)で扱っています。
なお、Cloudflareの公表は、影響を受けた顧客に個別に知らせたかどうかには触れていません。
AIの基盤を使う会社が確かめること
- Workers AIを使っている部署があるかを確認し、あれば、9月9日までにGLM-5.3を呼んでいたかを利用のログで見る。
- 呼んでいた場合は、どんな文書を渡していたかを担当者に聞く。社外秘や個人情報が入っていたなら、Cloudflareに問い合わせて、自社の依頼が混ざった応答の対象かを確認する。
- SGLangを自社で動かしているなら、0.5.22以降に更新する。Cloudflareは、ページの大きさと受け付ける長さを、起動の記録で突き合わせることも勧めている。
- 外部のAIのAPIに渡してよいデータの線引きを、社内の規程で見直す。
AIのAPIは、ほかの顧客と同じGPUを分け合って動いています。今回のような事故は、提供する側の試験と設定の隙間から起きました。渡す側にできるのは、混ざっても困らないデータだけを渡すことと、契約で事故の知らせ方を決めておくことでしょう。