10月23日から24日の2日間、各社の状況ページやお知らせには、10件の障害が載りました。Cloudflareが7件、Notion・サイボウズ・Zoomが1件ずつです。社員が「入れない」と言ってくる障害ばかりではなく、サイトは動いているのに記録が欠けたり、夜間の定期処理が抜けたりしたものも含まれます。
この記事では、10件を始まった時刻の順に並べ、止まり方の型ごとに自社の記録で確認する場所を整理しました。各社の発表の時点の内容で、その後の経過は各社の状況ページで確認してください。
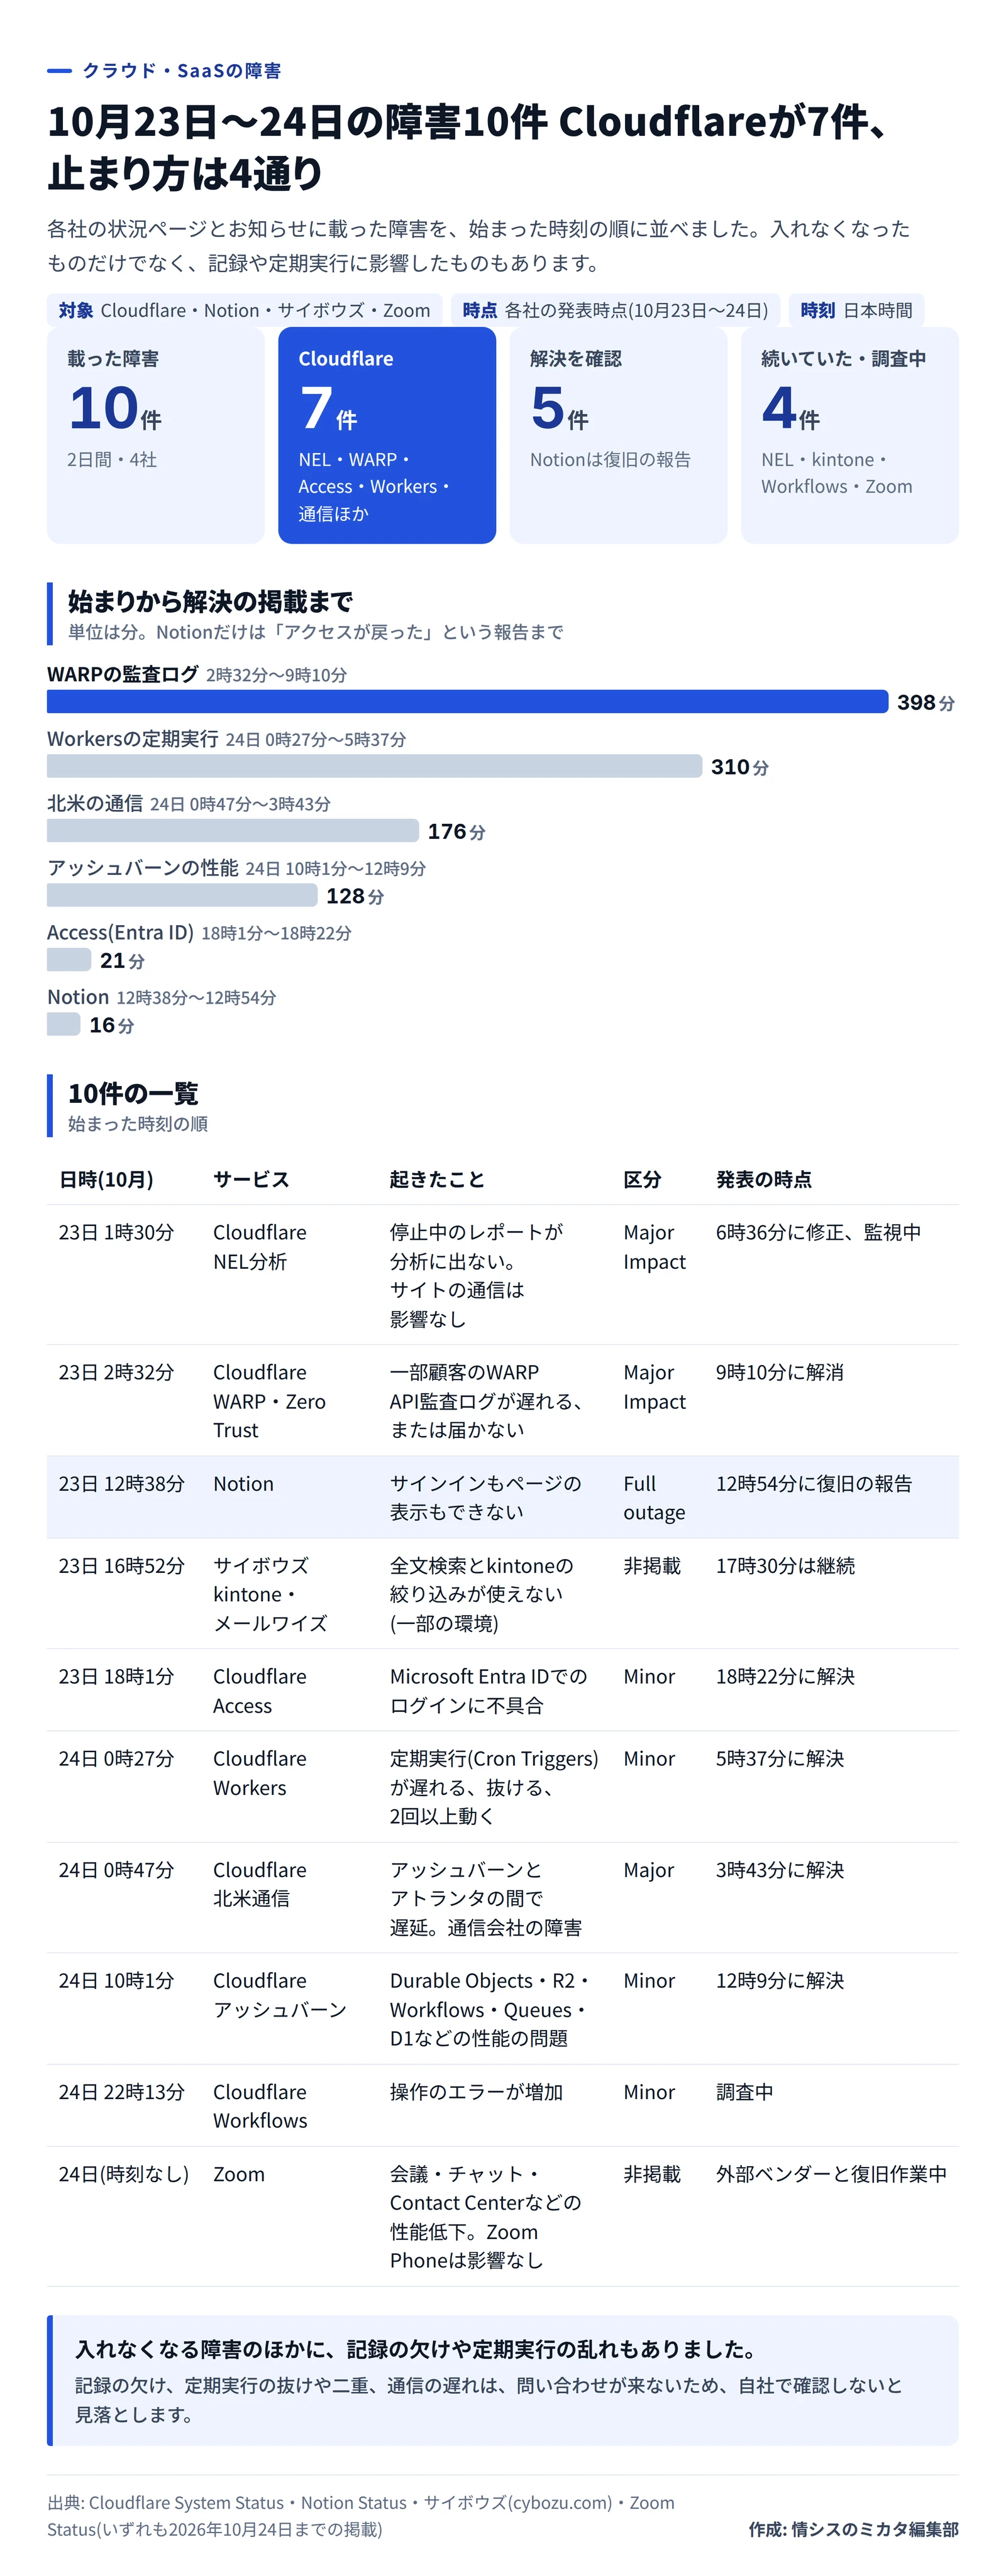
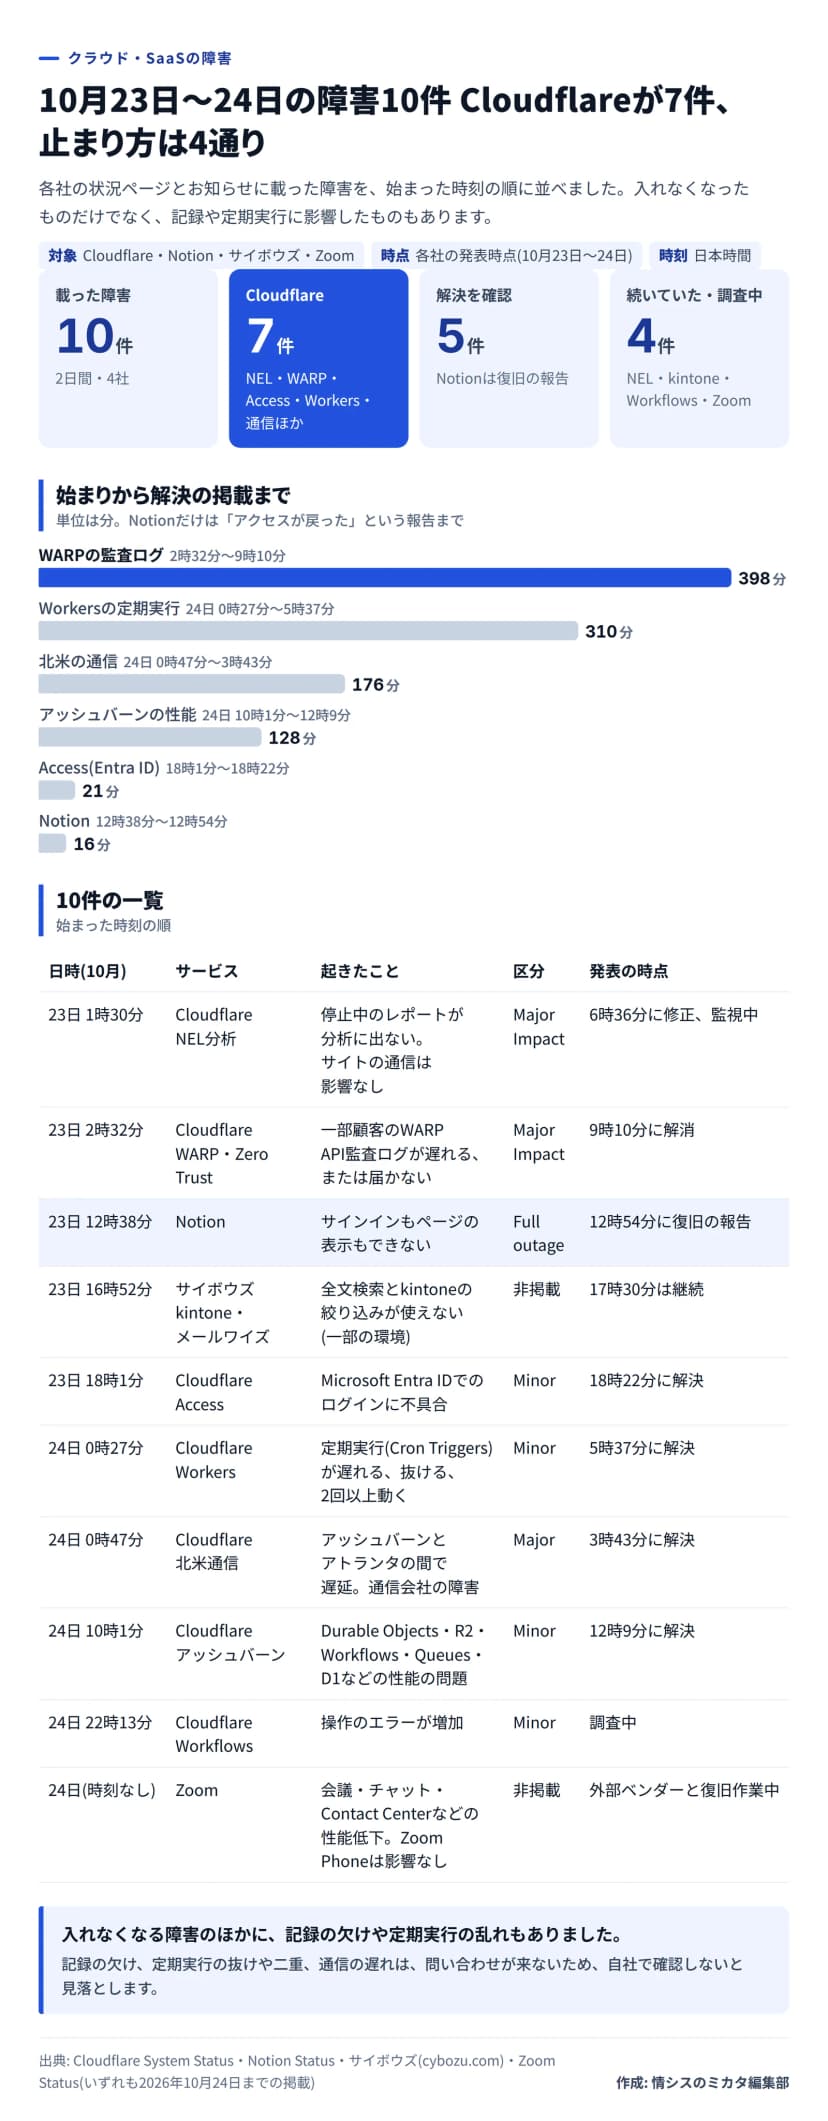 10月23〜24日の障害10件(各社の発表・日本時間)作成: 編集部 / 出典: Cloudflare・Notion・サイボウズ・Zoomの発表をもとに編集部が作成
10件を時刻の順に並べる
時刻はすべて日本時間です。「発表の時点」は、各社が記事の元の発表で示した最新の状態です。
| 日時 |
サービス |
起きたこと |
発表の時点 |
| 10月23日 1時30分 |
Cloudflare NEL分析 |
停止中のレポートが分析に出ない。サイトの通信は影響なし |
6時36分に修正、監視中 |
| 10月23日 2時32分 |
Cloudflare WARP・Zero Trust |
一部顧客のWARP API監査ログが遅れる、または届かない |
9時10分に解消 |
| 10月23日 12時38分 |
Notion |
サインインもページの表示もできない |
12時54分に復旧の報告 |
| 10月23日 16時52分 |
サイボウズ kintone・メールワイズ |
全文検索とkintoneの絞り込みが使えない(一部の環境) |
17時30分は継続 |
| 10月23日 18時1分 |
Cloudflare Access |
Microsoft Entra IDでのログインに不具合 |
18時22分に解決 |
| 10月24日 0時27分 |
Cloudflare Workers |
定期実行(Cron Triggers)が遅れる、抜ける、2回以上動く |
5時37分に解決 |
| 10月24日 0時47分 |
Cloudflare 北米通信 |
アッシュバーンとアトランタの間で遅延。通信会社の障害 |
3時43分に解決 |
| 10月24日 10時1分 |
Cloudflare アッシュバーン |
Durable Objects・R2・Workflows・Queues・D1などの性能の問題 |
12時9分に解決 |
| 10月24日 22時13分 |
Cloudflare Workflows |
操作のエラーが増加 |
調査中 |
| 10月24日(時刻の記載なし) |
Zoom |
会議・チャット・Contact Centerなどの性能低下。Zoom Phoneは影響なし |
外部ベンダーと復旧作業中 |
「解決」まで確認できたのは5件で、いちばん長かったのはWARPの監査ログの約6時間38分(398分)でした。Notionは「アクセスが戻ったはず」という報告までが16分で、解決の掲載は元の記事の時点では出ていません。
止まり方は4通り(編集部の整理)
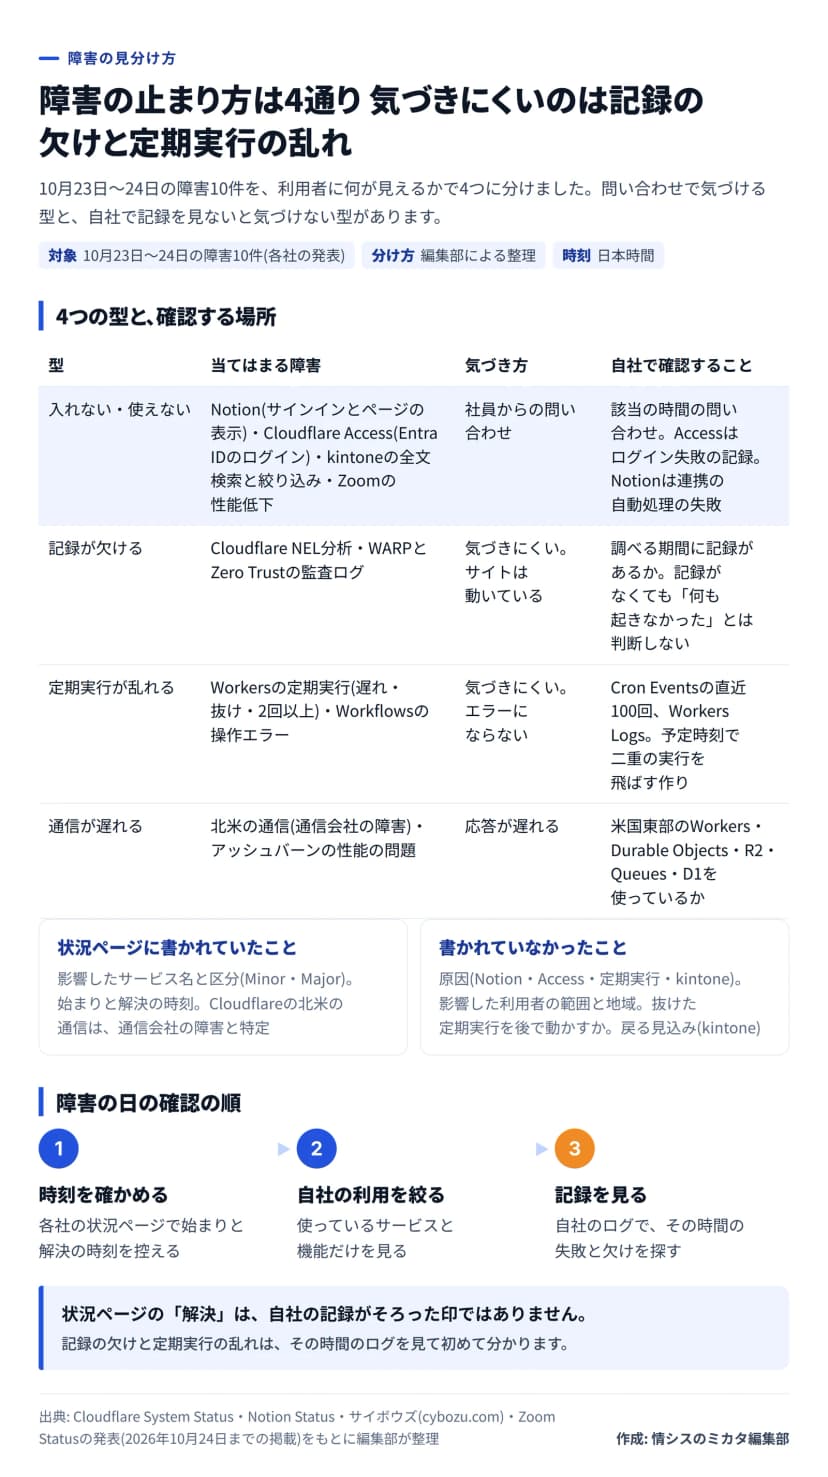
10件を、利用者に何が見えるかで分けると、4つの型になります。
 障害の4つの型と、自社で確認する場所作成: 編集部 / 出典: Cloudflare・Notion・サイボウズ・Zoomの発表をもとに編集部が整理
入れない・使えない型は、Notion、Cloudflare Access、kintoneの検索と絞り込み、Zoomです。社員からの問い合わせで気づけます。Notionの障害は12時38分、昼休みの時間帯でした。Cloudflare Accessは、Entra IDでログインしていた会社が約20分、社内のアプリに入れなかった可能性があります(Notionが昼に全面障害 サインインもページも開けず、約16分で復旧)。
記録が欠ける型は、NEL分析とWARPの監査ログです。サイトの通信は動いているので、利用者は何も気づきません。NELでは、停止中に受信したレポートが分析に出ないため、「その期間にエラーがなかった」とは読めません。WARPの監査ログは、原因がPDXリージョンの内部データパイプラインの容量問題で、遅れた分や届かなかった分がすべて配信されたかは、発表に書かれていません。
定期実行が乱れる型は、WorkersのCron Triggersです。遅れる、抜ける、2回以上動く、のどれもエラーとして表に出ません。毎時の集計や夜間のデータの取り込み、決まった時刻の通知に使っている会社は、記録を見ないと気づけません(Cloudflare障害 Workersの定期実行が抜け・重複、北米は通信遅延)。
通信が遅れる型は、北米の通信とアッシュバーンの性能の問題です。通信の障害は、通信会社の障害が原因と特定されました。米国東部のリージョンにあるWorkersやDurable Objects、R2、Queues、D1を使う場合に、応答が遅れた可能性があります。
なぜ記録の欠けと定期実行は気づきにくいのか
問い合わせは「使えない」ときに来ます。記録が欠けても、定期実行が1回抜けても、その時点では何も困りません。困るのは後日で、監査のために記録を出したときや、月末の集計の数字が合わないときです。
状況ページの「解決」は、サービス側の状態が戻ったという知らせです。抜けた定期実行を後で動かすのか、未配信のログを届けるのかは、10件の発表のどれにも書かれていません。原因が書かれていないものも多く、Notion・Access・定期実行・kintoneの4件がそうでした。
影響する会社・しない会社
- 影響する: Cloudflare AccessでEntra IDのログインを使い、社内のアプリを守っている会社です。18時ごろの約20分、社員がログインできなかった可能性があります。
- 影響する: WARPやZero Trustの監査ログを、調査や監査に使っている会社です。10月23日の2時台から9時台のログに欠けがないかを確認します。
- 影響する: Workersの定期実行やWorkflowsで、夜間の処理を動かしている会社です。10月24日の0時台から5時台の実行が抜けたり、二重になったりしていないかを見ます。
- 影響する: Notionの連携の自動処理や、kintoneの絞り込みで日々の一覧を作っている会社です。
- 影響しない(発表の範囲では): 該当のサービスや機能を使っていない会社です。ZoomはPhoneが影響なしとされていますが、会議やチャットを同じ会社で使っているなら、そちらは確認が要ります。
障害の日の確認の手順
- 時刻を控えます。 使っているサービスの状況ページで、始まりと解決の時刻を書き留めます。復旧の報告と「解決」の掲載は、別の時刻になることがあります。
- 使っている機能に絞ります。 同じCloudflareでも、NEL・WARP・Access・Workersは別のサービスです。自社が使っているものだけを見ます。
- 自社の記録で確認します。 Accessはログイン失敗の記録、WARPの監査ログは受け取り先の欠け、Workersの定期実行はCron Eventsの直近100回かWorkers Logsを見ます。Notionは、連携の自動処理が12時半から13時に失敗していないかを確認します。
- 二重実行に備えます。 Workersの処理には、予定の時刻(controller.scheduledTime)が渡されます。同じ予定の時刻で2回目が来たら飛ばす作りにすると、二重の請求や送信を避けられます(編集部の見立て)。
- 状況ページの通知を受け取ります。 各社の状況ページの購読で、障害の知らせを情シスの担当が受け取れるようにします。
状況ページの「解決」だけで終わりにせず、その時間のログまで見て、欠けがなければ記録に残します。欠けがあれば、各社のサポートに未配信分の扱いを問い合わせます。