Googleは2026年10月6日(米国時間)、手元の機械で動く埋め込みモデル「EmbeddingGemma 2」を公開しました。発表の中身はGoogle、EmbeddingGemma 2公開、端末内で形式をまたぐ検索へにまとめています。この記事では、社内の文書検索に使う前に情シスが確かめることを、Googleのモデルカードと開発者向けの手順書で整理します。
埋め込みモデルは、社内検索の「探す」部分を受け持つ
埋め込みモデルは、文や画像の意味を数字の並び(ベクトル)に変えるモデルです。意味が近いものは近い位置に、遠いものは離れた位置に置かれます。Googleの手順書は、埋め込みの大事な性質はベクトルどうしの距離だと説明しています。
社内検索では、先に文書をベクトルにして保存しておきます。質問が来たら質問もベクトルにし、近い順に文書を出します。言葉が一致しなくても、意味で探せるのが利点です。
RAG(検索で見つけた文書を生成AIに渡して答えを作る仕組み)では、埋め込みモデルは「探す」だけを受け持ちます。答えの文を書くのは別の生成モデルです。モデルカードは、想定する用途に「企業のナレッジベースを対象にしたRAG」を挙げています。
大きさ・入力・次元数は公式の表で確かめる
モデルカードと開発者ガイドの数字は次のとおりです。
| 項目 |
公式の記載 |
| パラメーター数 |
全部で7億4000万。文字だけなら2億7000万 |
| 入力 |
文字(コードを含む)、画像、動画、音声。混ぜて入れることもできる |
| 1回に入る量 |
8,192トークン。画像だけなら約29枚、音声だけなら約327秒 |
| 出力の次元数 |
768。512・256・128に短くできる |
| 言語 |
100以上の言語。一覧は載っていない |
| 重みのファイル |
Hugging Faceで約1.49GB |
| 動かす道具 |
sentence-transformers、llama.cpp、Ollama、LM Studioなど |
画像の部品(1億7000万)と音声の部品(3億)は、要るときだけ読み込めます。開発者ガイドによると、画像の部品はPDFやスライド、図表も扱います。文字の規程やマニュアルだけを探すなら、文字だけの構成で足ります。
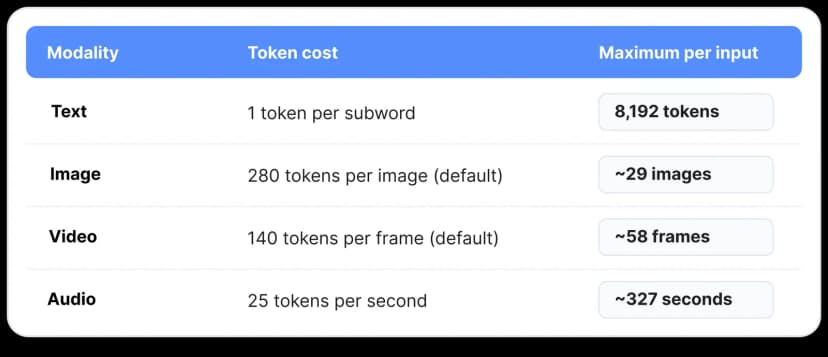 1回の入力に入る量。文字8,192トークン、画像約29枚、動画約58フレーム、音声約327秒出典: Google「EmbeddingGemma 2: The Developer Guide」(引用)
日本語については注意が要ります。モデルカードは「100以上の言語を理解する」としていますが、日本語に対応すると明記した箇所は、確かめた公式のページにありませんでした(2026年10月7日確認)。言語によって性能が同じとは限らない、とも書かれています。日本での提供は発表に書かれていません。
必要なメモリは、端末向けの版で数百MB
Googleのブログは、量子化(数値の精度を落として軽くする処理)をした場合の値を示しています。Pixel 11 Proで、文字だけなら約191MB、全部の部品を使うと約567MBです。
パソコンでの値は、Googleが配布先として案内するHugging FaceのLiteRT Communityに載っています。文字だけの端末向けの版は、ファイルが165MBです。
| 機械(CPUで実行) |
メモリ |
128トークンの文の処理 |
| Dell XPS 16(Intel Core Ultra シリーズ3) |
211MB |
71.7ミリ秒 |
| MacBook Pro M5 |
165MB |
31.3ミリ秒 |
メモリの測り方はOSごとに違い、直接は比べられないと注記があります。これらは量子化した端末向けの版の値です。Pythonの手順書どおりに動かす場合の必要メモリは、資料に書かれていません。
ベクトルを置く場所の大きさも見積もります。開発者ガイドによると、100万件を768次元で持つと約1.5GB、128次元なら約250MBです。256次元までは品質がほぼ保たれ、128次元は文字だけの大きな索引に向くとしています。
ライセンスはApache 2.0で、前の版とは条件が違う
EmbeddingGemma 2のライセンスはApache 2.0です。ブログは、商用利用を認めるライセンスだと説明しています。Hugging Faceの重みは、利用条件に同意する操作なしで取得できる設定でした(2026年10月7日確認)。
前の版のEmbeddingGemmaは違います。Gemmaの利用規約のページは、規約がかかるモデルの一覧に前の版を載せています。前の版を社内で使っている会社は、版ごとにライセンスを書き分けます。
Apache 2.0は、複製・改変・配布などを無償で認めています。配るときは、ライセンスの写しを付け、著作権の表示を残すことが条件です。保証はありません。
使い方の制限は別にあります。
Deployments must adhere to the Gemma Prohibited Use Policy.
出典: Google「EmbeddingGemma 2 model card」
(当社訳)導入にあたっては、Gemmaの禁止される使い方の方針に従う必要があります。
この方針は、同意なく人を追跡・監視することを禁じています。法律が求める同意なしに、個人の機微な情報を集めて処理することも禁じています。人事の資料や顧客の情報を検索の対象に入れる前に、個人情報の担当と確かめます。
クラウドの埋め込みAPIとは、データ・費用・運用で比べる
Google自身も、クラウドの埋め込みAPI「Gemini Embedding 2」を出しています。同じ会社の2つを並べると、違いが分かります。
| 軸 |
手元で動かす(EmbeddingGemma 2) |
クラウドのAPI(Gemini Embedding 2) |
| データ |
文書を社外に送らずに処理できる。オフラインでも動く |
文書の中身をAPIに送る。無料枠は内容が製品の改善に使われ、有料枠は使われない |
| 費用 |
モデルの利用料は無い。機械と運用の人手は自社 |
有料枠で、文字の入力100万トークンあたり0.20ドル |
| 運用 |
モデルの配布、機械の監視、索引の作り直しを自社で行う |
機械は提供元が動かす |
料金と扱いは、Gemini APIの料金のページで2026年10月7日に確かめた内容です。社外に出せない文書が中心なら、手元で動かす利点が大きくなります。文書の量が少なく、運用の人手が無い会社は、APIの費用のほうが小さく済む場合があります。
試す手順は、公式のノートブックで確かめられる
Googleは、Gemma Cookbookに「RAG with EmbeddingGemma 2」というノートブックを公開しています。社内ハンドブックを例に、人事・IT・経理・総務の8本の文書から答えを探す内容です。流れは次のとおりです。
pip install -U sentence-transformers transformers で道具を入れる- モデルを文字だけの構成で読み込む(下のコード)
- 文書を「title: 題 | text: 本文」の形にしてベクトルにする
- 質問を
prompt_name="Retrieval-query" を付けてベクトルにする
model.similarity で近さを出し、高い順に並べる- 答えの文も作るなら、見つけた文書をGemma 4 E2Bに渡す
from sentence_transformers import SentenceTransformer

model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},
)
手順書は、文書に題を入れると検索の精度が大きく上がるとしています。ノートブックは、近さが0.4未満なら「該当なし」にしています。一方で手順書は、関係のない文どうしでも近さが0.5を下回りにくいと注意しています。しきい値は、自社の文書で試して決めます。
情シスが決めるのは、置き場所・権限・更新の3つ
| 決めること |
中身 |
| 置き場所 |
モデルと索引を各自のPCに置くか、社内サーバーに置くか。索引は元の文書と同じ区分で管理する |
| 権限 |
モデルは近い文書を返すだけで、閲覧の権限を見ない。部署ごとに索引を分けるか、結果を権限で絞る |
| 更新 |
文書を直したら、その文書のベクトルを作り直す。担当と頻度を決める |
モデルカードは、検索結果の絞り込みなどの安全策は、導入する側の責任だとしています。次元数は、質問と文書でそろえる決まりです。画像や音声の部品を後から足しても、作り済みのベクトルは作り直さなくてよいとされています。
今日からできること
- 探したい文書の種類を書き出す。文字だけか、図の多いPDFや録音も含むかで、読み込む部品が決まる
- 検証用のPCで公式のノートブックを動かし、社内の規程を10本ほど入れて日本語の質問で試す
- ソフトウェアの台帳に「EmbeddingGemma 2 / Apache 2.0」と書く。前の版を使っていれば別の行にする
- 置き場所・権限・更新の担当を、1枚の表にまとめる
- 月に処理する文字の量を見積もり、APIの料金と、手元の機械・人手を並べて比べる
日本語での検索の質は、公式の資料からは分かりません。想定の質問と正解の文書の組を先に作り、上位に出た割合を記録します。そうすると、ほかのモデルとも同じ物差しで比べられます。
社員向けの生成AIのルールは、次のひな形をそのまま使えます。