11月11日から13日までの3日間で、監視 の知らせを運ぶ経路に1件ずつ障害 が出ました。11日はドコモの5G SAの通話とSMS、12日の未明はSlack、13日の朝はMicrosoft 365 のExchange Onlineです。夜中にサーバーが止まっても、知らせが届かなければ、気づくのは翌朝の出社のあとになります。
監視ツールを比べると、つい監視できる項目の多さに目が向きます。ただ、公式ページで確かめると、SNMPで機器の値を取る手段は8製品ともどこかの形で持っていました。差が出たのは2点。料金を何で数えるかと、異常の知らせをどの会社の経路で何本届けられるかです。1
8製品は、置き場所と料金の数え方で分かれる
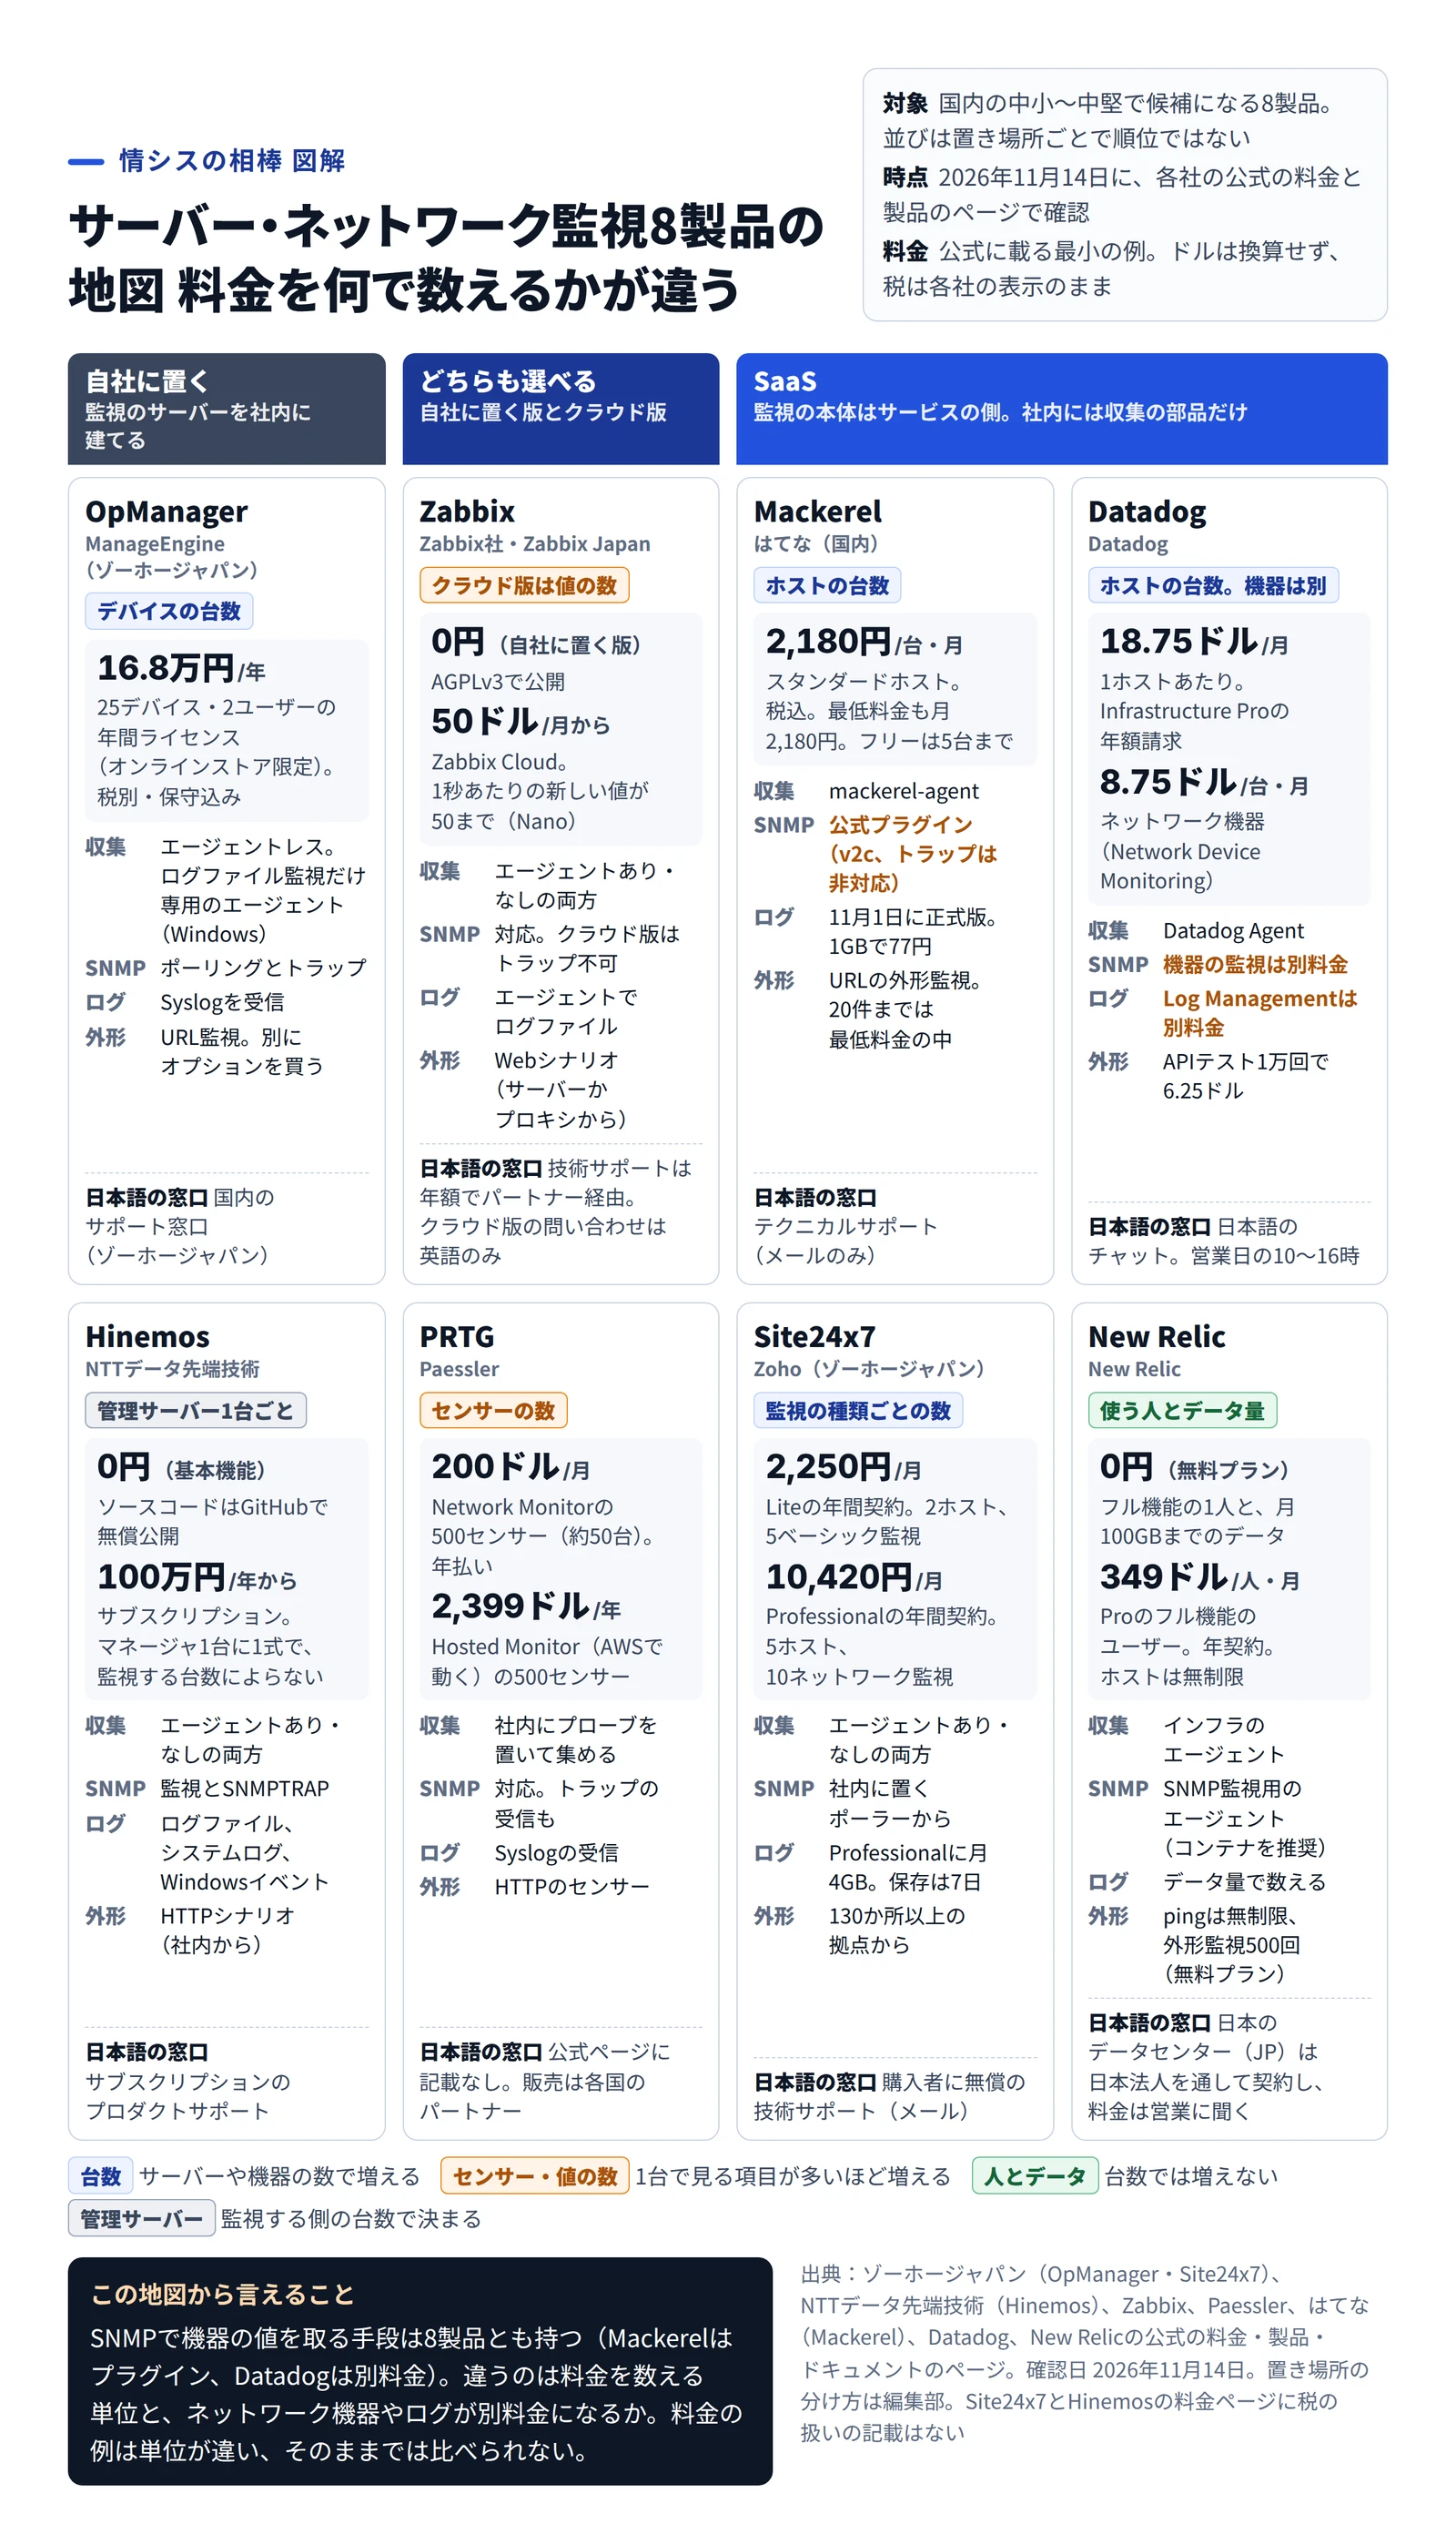
監視の本体を社内に置くか、サービスの側に置くかで、8製品は3つに分かれます。OpManagerとHinemosは社内に監視のサーバーを建てる形で、ZabbixとPRTGはクラウド版も選べます。Mackerel、Site24x7、Datadog、New RelicはSaaSです。
監視8製品を置き場所で3列に分け、料金の数え方と料金の例、収集の形、SNMP、ログ、外形監視、日本語の窓口を並べた地図 作成: 編集部 / 出典: 情シスの相棒編集部(各社の公式ページをもとに作成)
製品
置き場所
料金の数え方
公式に載る料金の例
OpManager
自社に置く
監視するデバイスの台数
25デバイスの年間ライセンスで年16万8,000円(税別)
Hinemos
自社に置く
管理サーバー(マネージャ)1台ごと
基本機能は無償。サブスクリプションは年100万円から
Zabbix
どちらも
自社に置く版は無償。クラウド版は1秒あたりの新しい値の数
Zabbix Cloudは月50ドルから
PRTG
どちらも
センサーの数
500センサーで月200ドル(年払い)。クラウド版は年2,399ドル
Mackerel
SaaS
ホストの台数(月の平均)
1台月2,180円(税込)
Site24x7
SaaS
監視の種類ごとのライセンス
Liteで月2,250円、Professionalで月1万420円(年間契約)
Datadog
SaaS
ホストの台数。ネットワーク機器は別に台数
1ホスト月18.75ドル(年額請求)
New Relic
SaaS
使う人の数とデータ量
無料プランは1人と月100GBまで。Proは1人月349ドル(年契約)
表で目を引くのは、数え方が5通りもあることです。台数で数える製品が多い一方、PRTGは監視の項目にあたるセンサーで、Zabbix Cloudは1秒あたりに届く新しい値の数で数えます。New Relicはホストの数に上限がなく、増えるのは使う人とデータの量です。
クラウド版を選ぶときは、窓口の言葉も見ておきたいところです。Zabbix Cloudのページによると、問い合わせは英語のみ。Zabbix Japanと国内のパートナーの支援は、準備が整い次第の案内です。PRTGのクラウド版は、PaesslerがAWSの26のリージョンで動かす形でした。
サーバー20台の1年分を、同じ前提で並べる
数え方が違うと、料金の例を横に並べても比べられません。そこで、社内のサーバー20台を1年監視する場合の額に直しました。ドルは円に換算していません。2
製品
20台で1年
計算のもと
Zabbix(自社に置く)
0円
ソフトは無償。技術サポートは年額で、価格は公表なし
Zabbix Cloud
600ドルから
月50ドル×12か月。1台100項目を1分ごとに取ると1秒に約33の値で、Nanoの50に収まる
Hinemos
0円、または100万円
基本機能は無償。サブスクリプションのEssentialは年100万円で、台数によらない
Site24x7
16万3,080円
Liteの月2,250円に、追加10サーバーの月5,670円を2つ。22台分を12か月
OpManager
16万8,000円(税別)
25デバイスの年間ライセンス(オンラインストア限定)。保守込みで、ユーザーは2人
Mackerel
52万3,200円(税込)
2,180円×20台×12か月
PRTG
2,400ドル
500センサー(約50台)の月200ドル×12か月。1台25センサーまで
Datadog
4,500ドル
18.75ドル×20台×12か月
New Relic
0ドル、または4,188ドル
無料プランは1人と月100GBまで。Proで1人なら349ドル×12か月
円で払う有料の例は、16万3,080円から100万円まで開きました。ただ、どの額も「20台」の意味が少しずつ違います。Site24x7は22台分、OpManagerは25デバイスまでを買った額で、PRTGは約50台分の枠のうち20台を使う計算です。
ネットワーク機器を30台足すと、増え方の差がはっきり出ます。円とドルを換算しなくても、増える割合なら比べられます。
製品
サーバー20台
機器30台を足した50台
増え方
OpManager
16万8,000円
25万8,000円
約54%
Datadog
4,500ドル
7,650ドル
70%
PRTG
2,400ドル
2,400ドル、または4,296ドル
0%か約79%
Zabbix Cloud
600ドル
1,200ドル
100%
Hinemos
100万円
100万円
0%
New Relic
4,188ドル(Proで1人)
4,188ドルと、月100GBを超えたデータの分
データ量しだい
OpManagerはIPアドレスのある監視対象を1デバイスと数えるので、機器もサーバーと同じ1台です。Datadogは機器を別の製品で数え、1台月8.75ドルの分が上乗せされる形です。PRTGは500センサーを50台で分けると1台10センサーで、収まるかどうかで額が変わりました。足りなければ1,000センサーの月358ドルに上がります。Zabbix Cloudは50台なら1秒に約83の値となり、Microの月100ドルに移る計算です。
サーバーよりスイッチやルーターが多い会社ほど、この増え方の差が年額に効いてきそうです。台数で数えるSaaSなら機器が別料金かどうかを、センサーで数える製品なら機器1台に要るセンサーの数を、見積もりの前に確かめておくとよいでしょう。
トラップとログは、製品で扱いが違う
SNMPとログ、外形監視の3つは、8製品ともどこかの形で持っていました。違いが出るのは、収集の形とSNMPのトラップ、ログの扱いです。
製品
収集の形
ネットワーク機器(SNMP)
ログ
OpManager
エージェントレス
ポーリングとトラップ
Syslog。ログファイルはWindowsだけで、専用のエージェント
Hinemos
エージェントあり、なしの両方
監視とSNMPTRAP
ログファイル、システムログ、Windowsイベント
Zabbix
エージェントあり、なしの両方
対応。Zabbix Cloudはトラップ不可
エージェントでログファイル
PRTG
社内に置くプローブ
対応。トラップの受信も
Syslogの受信
Mackerel
mackerel-agent
公式プラグイン(v2c、トラップは非対応)
11月1日に正式版。1GBで77円
Site24x7
エージェントあり、なしの両方
社内に置くポーラーから
Professionalは月4GB(保存7日)
Datadog
Datadog Agent
Network Device Monitoring(別料金)
Log Management(別料金)
New Relic
インフラのエージェント
SNMP監視用のエージェント(コンテナを推奨)
取り込むデータ量で数える
トラップを受けられない形が2つありました。MackerelのSNMPのプラグインはv2cで値を取りにいく作りで、トラップには対応していません。Zabbixは自社に置く版ならトラップを受けますが、Zabbix Cloudでは使える監視の方法からSNMPトラップが外れます。機器が自分から送る異常の知らせを受けたいなら、社内に受け口を残す設計になるでしょう。
外形監視は、どこから見るかで意味が変わります。OpManager、Hinemos、Zabbix、PRTGを社内に置いた場合、HTTPやURLの監視は社内の監視サーバーから自社のサイトを見にいく形です。OpManagerでURL監視を使うには、Liteデバイスオプションも要ります。インターネットの出口が止まれば、監視サーバーごと外に出られず、知らせも出せないかもしれません。SaaSの4製品は、Site24x7の130か所以上の拠点のように、社外のサービスの側から見にいきます。ログを長く残す話は、ログ管理・SIEM10製品の地図 で比べられます。
知らせの経路は、1つの会社に寄りやすい
メールで知らせる機能は、8製品すべてにありました。困るのは受け取る側です。Microsoft 365を使う会社なら、監視の知らせの宛先もたいていExchange Onlineの箱でしょう。
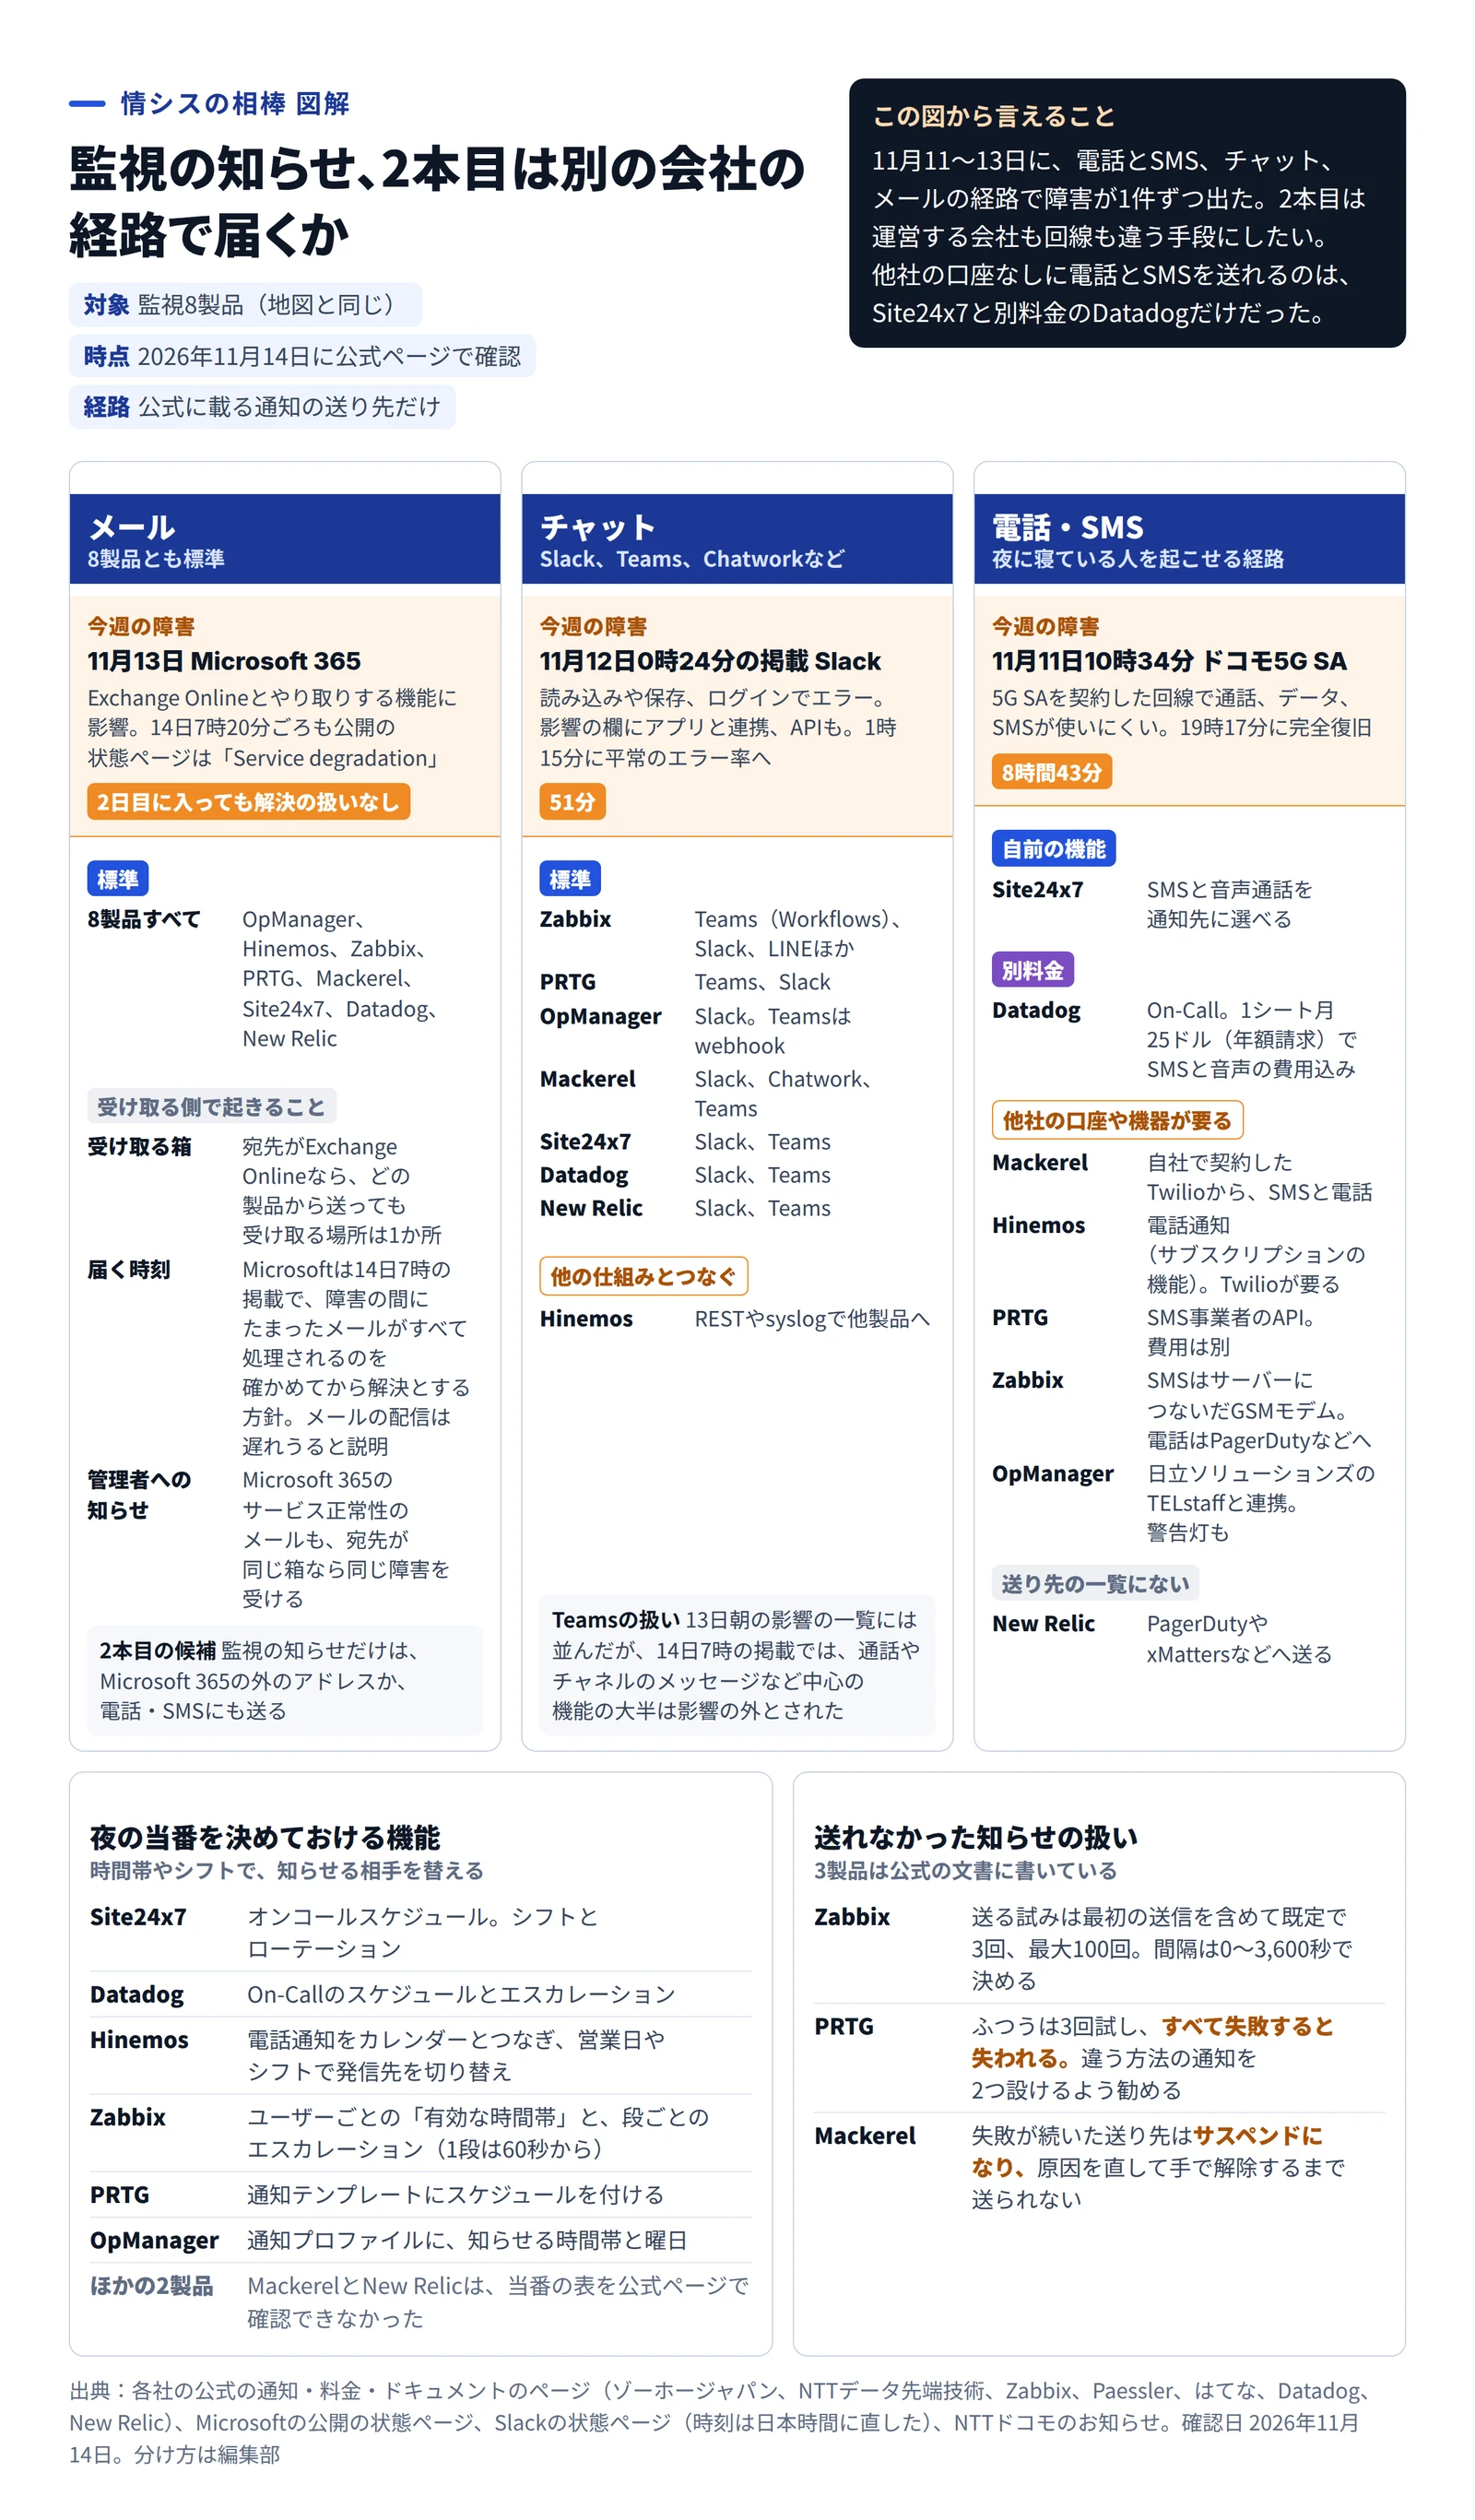
障害が出たメール、チャット、電話・SMSの経路ごとに、8製品の知らせ方と当番、送れなかった知らせの扱いを並べた図 作成: 編集部 / 出典: 情シスの相棒編集部(各社の公式ページと障害の掲載をもとに作成) 13日朝の障害では、影響を受けたのはExchange Onlineとやり取りする機能でした。Microsoftは14日7時の掲載で、メールの配信は遅れうると説明しました。障害の間にたまったメールがすべて処理されるのを確かめてから、解決とする方針です。Microsoftが受け取った知らせは、遅れて届く見込みでしょう。受け取りの段階で断られた分は、送る側の製品が何回試すかで決まります。14日7時20分ごろも、公開の状態ページは「Service degradation」のままでした。
Teamsはどうでしょう。13日朝の影響の一覧には並びましたが、14日7時の掲載では、通話や会議への参加、グループチャット、チャネルのメッセージなど中心の機能の大半は影響を受けていないとされました。経過はMicrosoft 365の障害の図解 で追えます。
それでも、メールとTeamsはどちらもMicrosoftのサービスです。2本あるように見えて、運営する会社は1つ。別の会社のチャットに逃がしても、Slackでは12日0時24分の最初の掲載から平常のエラー率に戻るまでの51分、読み込みやログインでエラーが出ていました。影響の欄には、アプリと連携、APIも並んでいます。
製品
チャット
電話・SMS
当番の機能
OpManager
Slack。Teamsはwebhookで
日立ソリューションズのTELstaffと連携。警告灯も
通知プロファイルに時間帯と曜日
Hinemos
RESTやsyslogで他製品へ
電話通知(サブスクリプションの機能。Twilioが要る)
カレンダーとつなぎ、営業日やシフトで発信先を切り替え
Zabbix
Teams(Workflows)、Slack、LINEほか
SMSはGSMモデム。電話はPagerDutyなどへ
ユーザーごとの有効な時間帯とエスカレーション
PRTG
Teams、Slack
SMS事業者のAPI(費用は別)
通知テンプレートにスケジュール
Mackerel
Slack、Chatwork、Teams
自社で契約したTwilioからSMSと電話
公式ページで確認できず
Site24x7
Slack、Teams
SMSと音声通話
オンコールスケジュール
Datadog
Slack、Teams
On-Call(1シート月25ドル。SMSと音声の費用込み)
On-Callのスケジュールとエスカレーション
New Relic
Slack、Teams
送り先の一覧になし(PagerDutyなどへ)
公式ページで確認できず
他社の口座なしに電話とSMSを送れるのは、Site24x7と、別料金のOn-Callを足したDatadogだけでした。MackerelとHinemosはTwilio、PRTGはSMS事業者と、別の会社の口座を自分で用意します。
手間に見えますが、運営する会社が分かれる点では利点にもなります。ただし、SMSと電話は最後に携帯の回線を通ります。11日のドコモの障害は、5G SAを契約した回線で通話とSMSが使いにくくなったものでした。担当者の携帯がみな同じ会社の同じ契約なら、2本目は回線のところで1本に戻ってしまいます。社用携帯の契約の見分け方は、ドコモ5G SAの障害の記事 で確かめられます。
PRTGの手引きにも、同じ考え方がはっきり出てきます。
To never miss a notification, we recommend that you always set up at least two notifications with different notification methods for a notification trigger, for example, one email notification and one SMS notification.
出典: Paessler「Notification Delivery」
方法を2つにするだけでは、まだ足りないと編集部は考えています。運営する会社と通る回線まで分けて、初めて2本目になるからです。メールとTeamsの組み合わせは、方法は2つでも会社は1つでした。
送れなかった知らせの行方は、3製品で違う
送るのに失敗した知らせの扱いは、公式の文書で確かめられた3製品でばらばらでした。
Zabbixは、送る試みの回数と間隔を自分で決められます。回数は最初の送信を含めて既定で3回、最大100回。間隔は0〜3,600秒です。PRTGの手引きによれば、ふつうは3回続けて試し、すべて失敗するとその知らせは失われます。
Mackerelは、失敗が続いた送り先そのものを止める作りです。特定の送り先への失敗が一定期間続くと、その送り先はサスペンド、つまり一時停止になります。原因を直してから手で解除するまで、そこには知らせが送られません。
障害が明けてチャットが戻っても、監視の送り先が止まったままでは、次の異常に気づけません。チャンネルの一覧に警告が出ていないかを、障害の翌朝に一度見ておけば、この取りこぼしは防げるはずです。
ひとり情シスの夜は、誰の電話を鳴らすか
担当が1人の会社では、夜の知らせの受け手も1人です。時間帯で送り先を替える機能があれば、昼はチャット、夜は電話と分けられます。
Site24x7のヘルプは、その使い方を例に挙げていました。営業時間内はメールだけにし、18時から翌朝8時はオンコールの担当者にSMSや音声通話で送る形です。オンコールスケジュールでは、シフトごとに受けるグループを決め、月ごとなどで順番を回せます。
DatadogのOn-Callは1シート月25ドル(年額請求)で、SMSと音声の通知の費用もシート料金に含まれます。1人なら年300ドル。ただ、請求の対象は一度に割り当てたシートの最大数で、同じ請求期間の中で人を替えると2シート分になります。当番を頻繁に回すなら、期間中にシートを持つ予定の全員の人数で契約するのが、Datadogの勧めです。
自社に置く製品では、OpManagerが通知プロファイルに時間帯と曜日を決められます。Zabbixもユーザーごとに知らせる時間帯を決められ、エスカレーションで、解決しない障害を上のユーザーグループに回せます。1段の長さは60秒からです。Hinemosの電話通知も、カレンダーとつないで営業日やシフトで発信先を替えられます。
もう1つの穴は、社内に置いた監視サーバーそのものが止まる夜です。監視サーバーが落ちれば、異常を見つける側も知らせる側もいなくなるでしょう。
Mackerelの死活監視は、エージェントからの定期的な投稿を見ていて、一定期間届かないとアラートを出します。Site24x7にも、決まった間隔で届くはずの通信が来ないと知らせるHeartbeatモニターがあります。社内の監視サーバーを外から監視する役は、こうしたSaaSの小さな契約に任せられそうです。
うちの会社に合う組み方
Microsoft 365が中心で、社内のサーバーが十数台の会社は、メールを1本目に残し、2本目を電話かSMSにします。ここで初めて、電話をどう送るかが製品選びの軸になります。
スイッチやルーター、無線のアクセスポイントが多い会社では、台数で数えるOpManager、センサーで数えるPRTG、機器が別料金のDatadogで、年額の増え方が分かれます。トラップを受けたいなら、MackerelとZabbix Cloudは外れます。
クラウドのサーバーとアプリまで見たい会社は、SaaSの4製品が候補です。New Relicは台数では数えない一方、フル機能で使う人と、取り込むデータの量で額が上がります。
夜は保守会社に任せる会社なら、エスカレーションの2段目に保守会社の連絡先を入れられるかを、先に確かめます。
2本目の経路を確かめる手順
いまの監視の送り先を書き出し、運営する会社と通る回線ごとに分けます。メールとTeamsは、Microsoftの1本と数えます。
Microsoft 365の外にある経路を1つ決めます。電話かSMSなら、受ける携帯の会社と、5G SAの契約かどうかも控えておきます。
夜間の時間帯だけ2本目にも送るよう設定します。Site24x7とOpManagerなら通知プロファイル、Zabbixならユーザーの有効な時間帯、PRTGなら通知テンプレートのスケジュールです。
平日の昼に、試しの障害を1件起こします。監視対象のサービスを止めるなどして、2本目に何分で届くかを測ります。
Mackerelを使っているなら、障害が明けた翌朝に、チャンネルの一覧にサスペンドの警告が出ていないかを見ます。
手順4で測った時間が、夜中に待つ時間のおよその目安になります。障害が起きてから、枕元で電話が鳴るまでの長さです。