Microsoft 365 が止まっている間、社員に「いま止まっています」と伝える手段は残っているでしょうか。11月13日朝のMicrosoft 365の障害 では、Exchange OnlineとMicrosoft Teams 、SharePoint Onlineがそろって影響の一覧に入りました。公開の状態ページには、管理者が管理センターに入れないおそれがある、という注記も付いています。
13日7時11分の掲載でも、状態は「サービスの低下」のままでした。11月10日夜から13日朝までには、AWSの東京リージョンやSlack、ドコモの5G SAなど、ほかにも主な障害が7件、各社の公式ページに載りました。
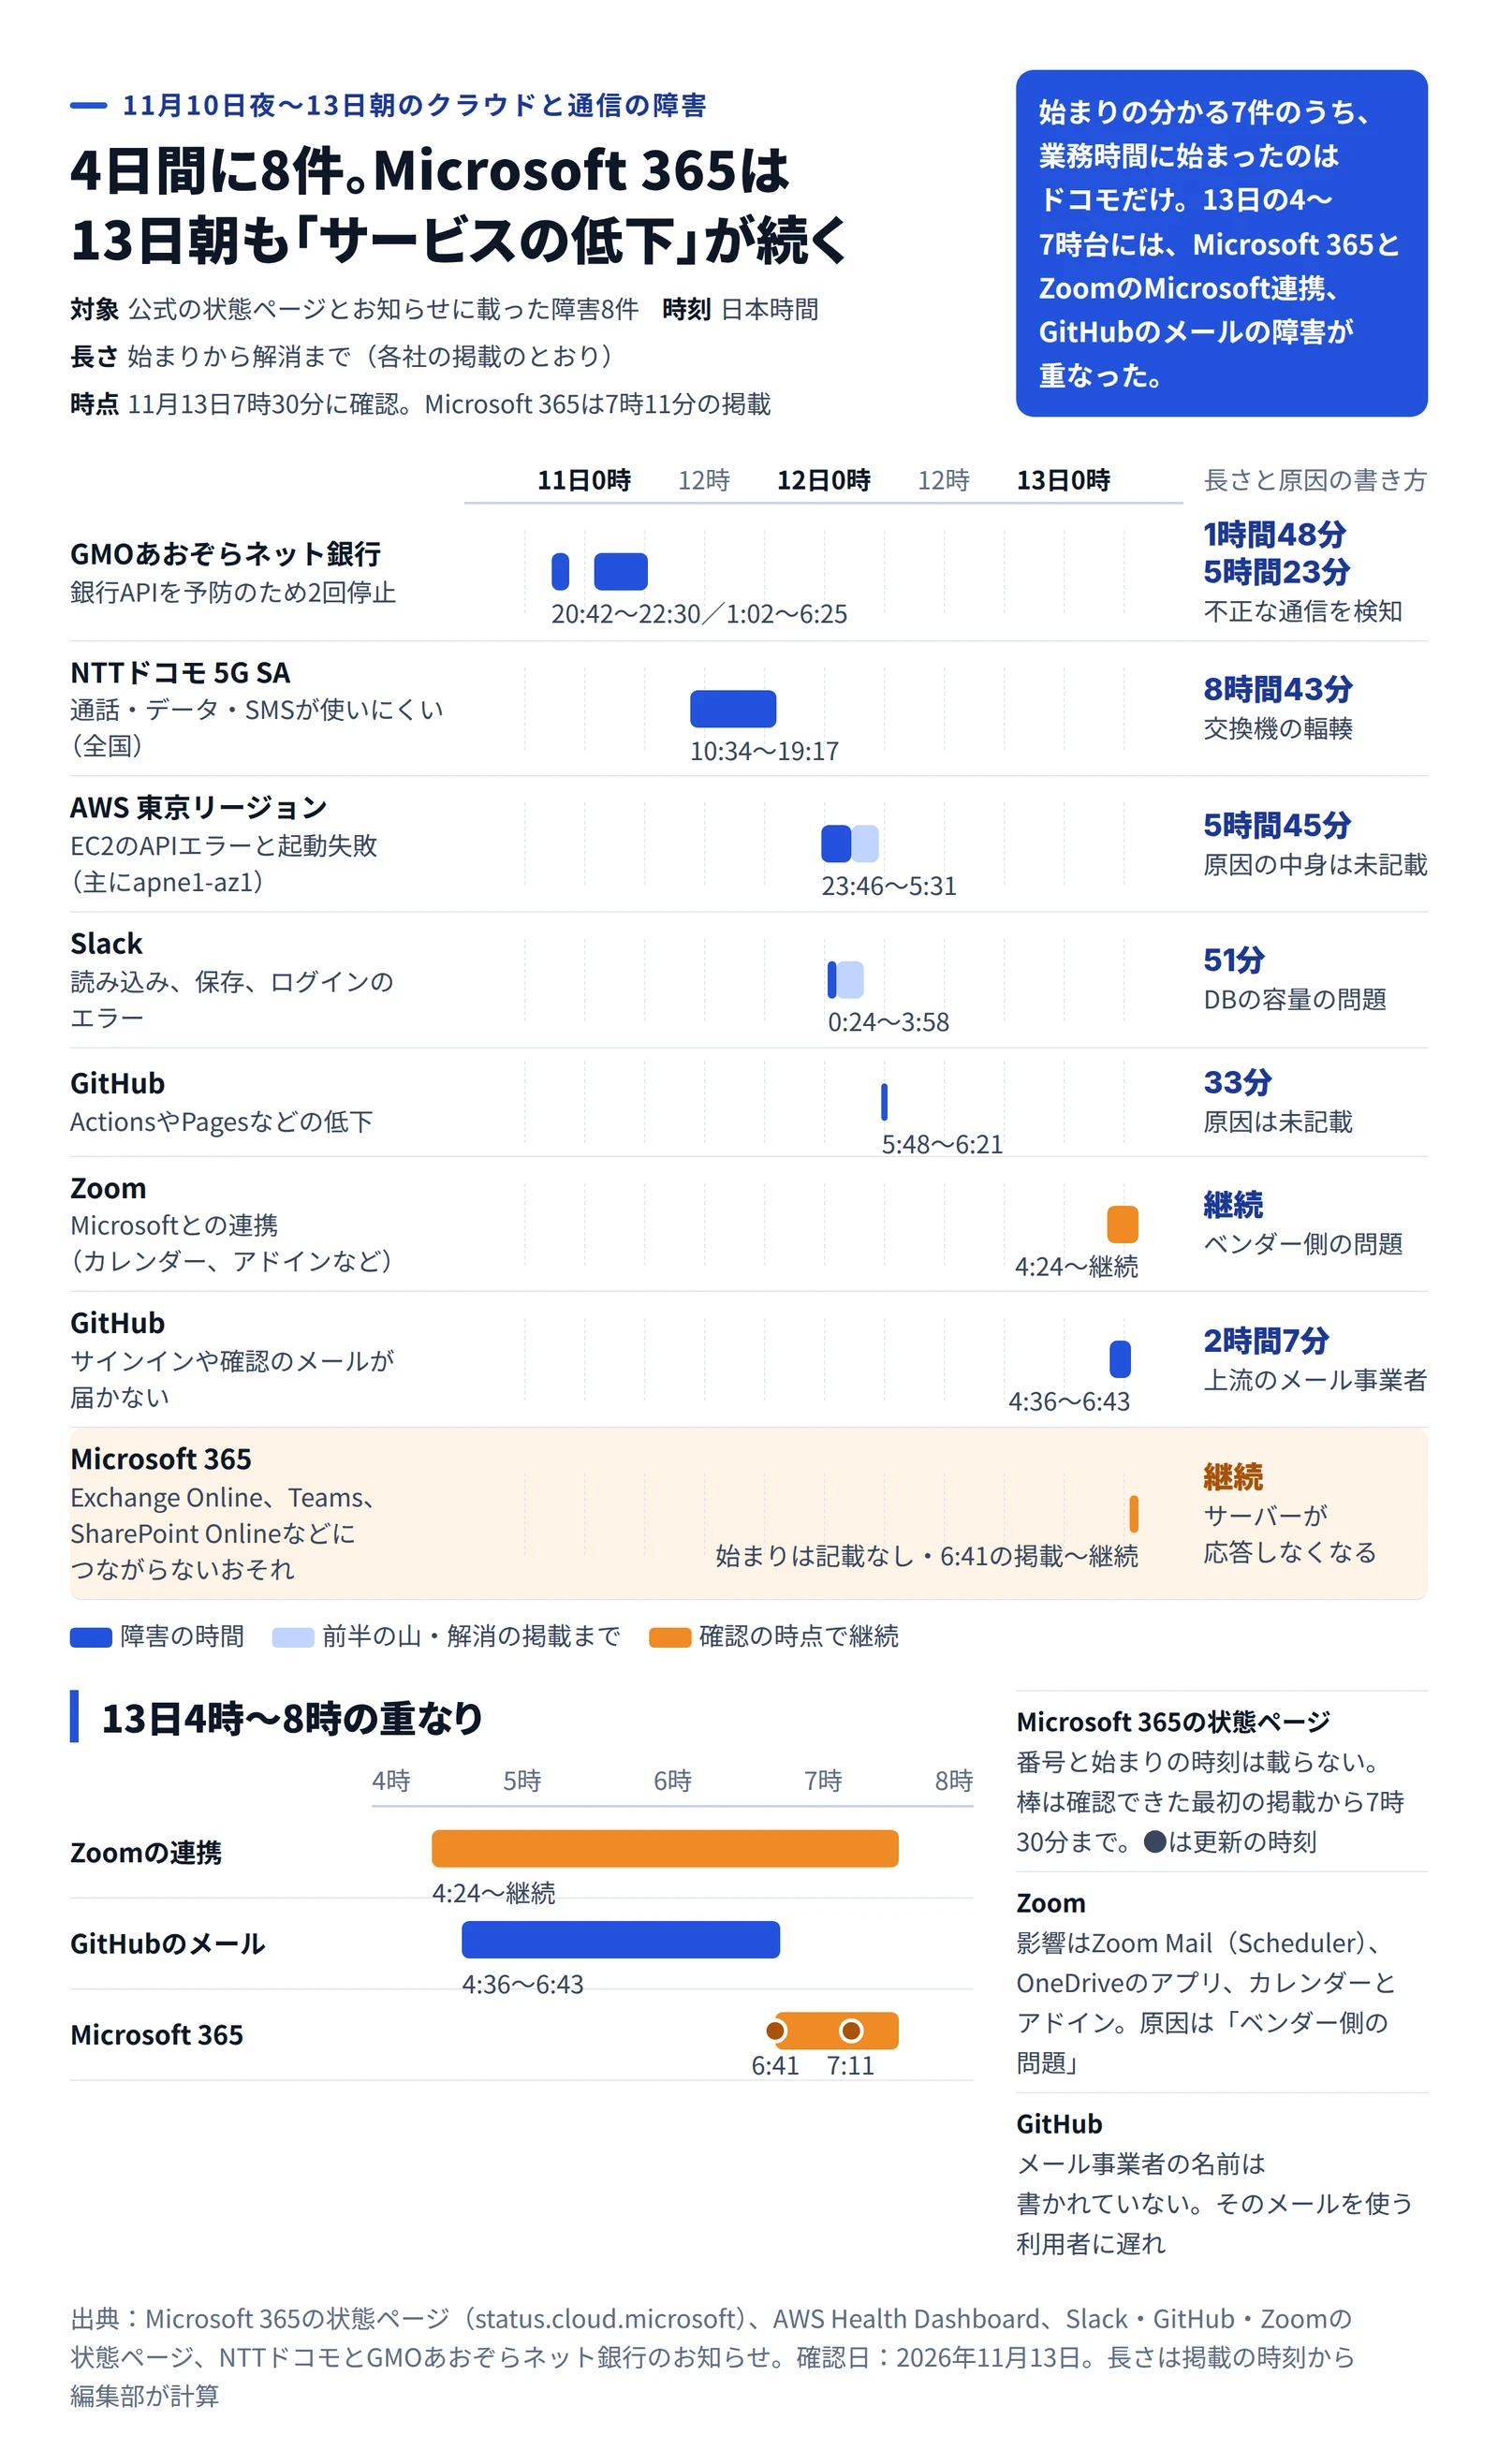
11月10日夜〜13日朝の障害8件と、13日朝の重なり(日本時間) 作成: 編集部 / 出典: 各社の公式ページをもとに編集部が作成 4日間の8件を、始まった順に
時刻はすべて日本時間です。長さは、各社が示した始まりと解消の時刻から数えました。
始まり
サービス
起きたこと
長さ
原因として書かれたこと
11月10日20時42分
GMOあおぞらネット銀行
銀行APIを予防のため停止。11日1時2分に再び停止
1時間48分と5時間23分
外部からの不正な通信を検知
11月11日10時34分
NTTドコモの5G SA
5G SAを契約した回線で、通話とデータ通信、SMSが使いにくい(全国)
8時間43分
5G SAの契約者を収容する交換機の輻輳
11月11日23時46分
AWSの東京リージョン
主にapne1-az1で、EC2のAPIエラーと起動の失敗。その後、新しいインスタンスへの接続の問題
5時間45分
原因は特定済みとしたが、中身は書かれていない
11月12日0時24分
Slack
読み込みや保存、ログインでエラー
51分(掲載から平常のエラー率まで)
直近のデータベースの変更が引き金とみる容量の問題
11月12日5時48分
GitHub
Actions、Pages、Webhooks、Copilotの低下
33分
書かれていない
11月13日4時24分(掲載)
Zoom
Microsoftとの連携(Zoom Mail、OneDriveのアプリ、カレンダーとアドイン)
7時台も継続
ベンダー側の問題
11月13日4時36分
GitHub
サインインやメールアドレスの確認、パスワードの再設定のメールが届かない
2時間7分
上流のメール事業者の低下
11月13日(記載なし)
Microsoft 365
Exchange Online、Teams、SharePoint Onlineなどにつながらないおそれ
14日7時の掲載で回復が続く。解決の扱いはまだ
サーバーの中の処理があふれ、応答しなくなる。最近の設定の変更が関わった可能性も調査
始まりの時刻が分かる7件のうち、業務時間の9時から18時に始まったものはドコモの1件だけでした。ほかは日本の夜から明け方にかけてです。米国太平洋時間に直すと、AWSの障害は午前6時46分に始まり、Slackは午前7時24分、ZoomとGitHubのメールは午前11時台に掲載がありました。どれも米国の朝から昼にあたります。
日本の担当者が寝ている間に始まり、朝に掲載を見て気づく。米国の会社のサービスでは、そんな順番になりやすいのかもしれません。Microsoft 365は7時11分の掲載でも続いており、8時6分の掲載でも一部の地域で回復が始まった段階です。9時の始業までにすべて戻るかは見通せませんでした。14日7時の掲載でも回復が続いているとしつつ、解決の扱いにはしていません。
影響の一覧に、知らせるツールが並んだ
7時11分の掲載で、影響を受けうるサービスに挙がった名前は12あります。Exchange OnlineとTeams、SharePoint Onlineに加えて、Copilot、Defender XDRとDefender for Office 365、Intune、Purviewが並びます。PlannerやTo Do、Microsoft 365 Apps管理センターも入り、Power BIは秘密度ラベルの付いたレポートをPDFに書き出す操作だけが対象です。
全社メールはExchange Online、チャットと会議はTeams、社内ポータルの掲示はSharePoint Online。そんな使い分けの会社は多いはずです。だから、この3つが同時につながらないと、障害を知らせるツールそのものがなくなります。
Microsoftの説明は、掲載のたびに少しずつ進みました。6時41分の掲載によると、影響を受けたサーバーを再起動して確かめながら戻している途中で、直近の少数の設定の変更を元に戻すかも検討中でした。その前の段階では、別の方法の正常性チェックを一部のサーバーで試し、そのサーバーは戻ったとあります。7時11分の掲載は、サーバーの中の中心的な処理があふれて応答しなくなり、処理の能力が落ちていると説明しました。
8時6分の掲載では、影響を受けたサーバーの一部を戻し、今のところ安定しているとしました。通信や接続をほかの経路へ移せるところは移し、一部の地域で限られた回復が見られるといいます。負荷を減らす対策を特定の場所で始め、効果があればほかの場所にも広げる方針です。容量が戻るにつれて、利用者はアプリがつながり直した順に少しずつ回復する、と書かれています。次の更新は9時30分の予定です。
14日7時(日本時間)の掲載では、影響のあった環境で回復が続いているとしました。影響が大きかったため、追加の対策が要らないかを長めに見守り、障害の間にたまったメールがすべて処理されるのを確かめてから解決とする方針です。公開の状態ページの表示は「サービスの低下」のままで、個人向けの製品にも表示が出ていました。次の更新は14日11時30分の予定です。
この掲載で、影響の中身もはっきりしました。影響を受けたのは、各サービスのうちExchange Onlineとやり取りする機能です。Teamsは、通話や会議への参加、グループチャット、チャネルのメッセージといった中心の機能は影響を受けておらず、予定表を使う会議の作成や招待、ライブイベントの作成などが失敗したとしています。SharePoint Onlineも、保存したファイルを開くことはでき、社外との共有などに影響が出ました。ほかに、IntuneのPCの登録や準拠ポリシーの確認、Purview Customer Keyを使うWindows 365のクラウドPCへの接続も挙がっています。
影響の一覧に名前が載ることと、その製品が丸ごと止まることは違いました。13日朝の一覧だけを見て「Teamsも使えない」と社内に知らせた会社もあったはずです。次に同じ掲載が出たときは、一覧の名前だけで止まったと決めず、メール、Teamsのチャット、SharePointのファイルを手元で1つずつ試してから、使える手段を案内するほうが確かです。
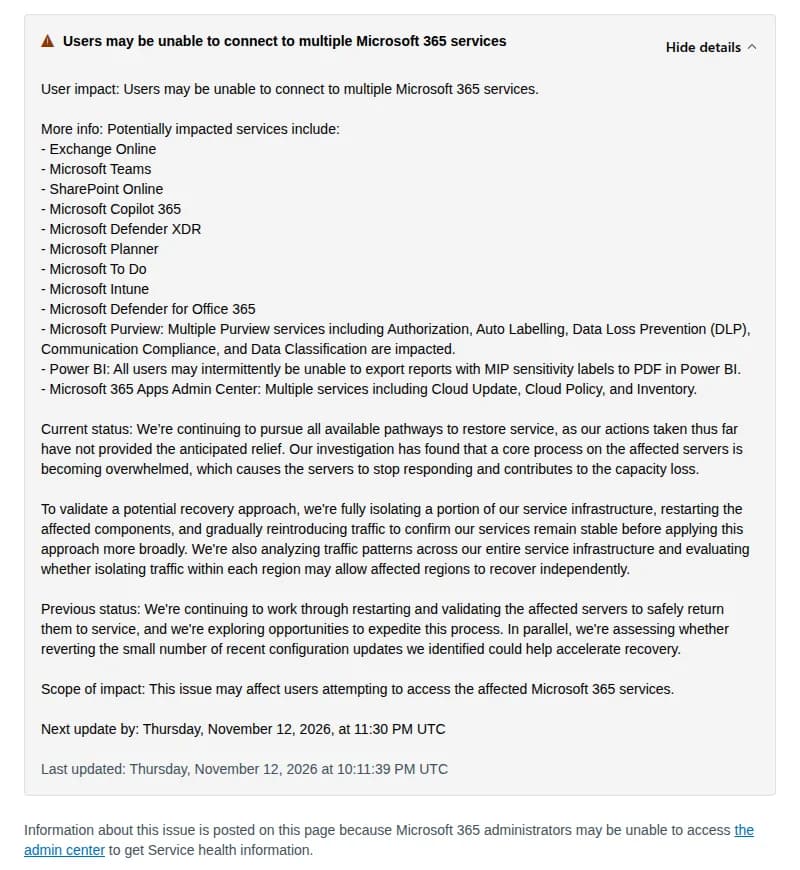
We’re continuing to pursue all available pathways to restore service, as our actions taken thus far have not provided the anticipated relief.
出典: Microsoft service health status
それまでの手当てでは、期待した回復が得られていない。そう認める一文です。インフラの一部を切り離して回復の方法を試す段階で、地域ごとに通信を分ける案もまだ検討中。日本の朝のうちに戻る前提で、今日の予定を組むのは避けたいところです。
Purviewの行も見落とせません。DLPや自動ラベル付け、データ分類も影響を受けると書かれていました。メールとTeamsが戻っても、障害の時間に作ったファイルや送ったメールにラベルが付いたか、DLPの判定が働いたかは、別に見ないと分かりません。
14日7時の掲載でも、障害の始まりの時刻も、日本の利用者に影響したかも、原因の詳しい説明も、公開のページに出ていません。Xの@MSFT365statusの投稿も、確認できていません。
Microsoft 365の状態ページの掲載(11月13日7時11分の更新) 出典: Microsoft (引用) 管理センターと公開のページで、分かることが違う
Microsoftの手引きが挙げる、状況を見る場所は3つです。管理センターの「サービス正常性」と、管理センターにサインインできないときの公開の状態ページ、それにXの@MSFT365statusです。公開の状態ページにも、障害の掲載とあわせて、そこに載せる理由が書かれています。
Information about this issue is posted on this page because Microsoft 365 administrators may be unable to access the admin center to get Service health information.
出典: Microsoft service health status
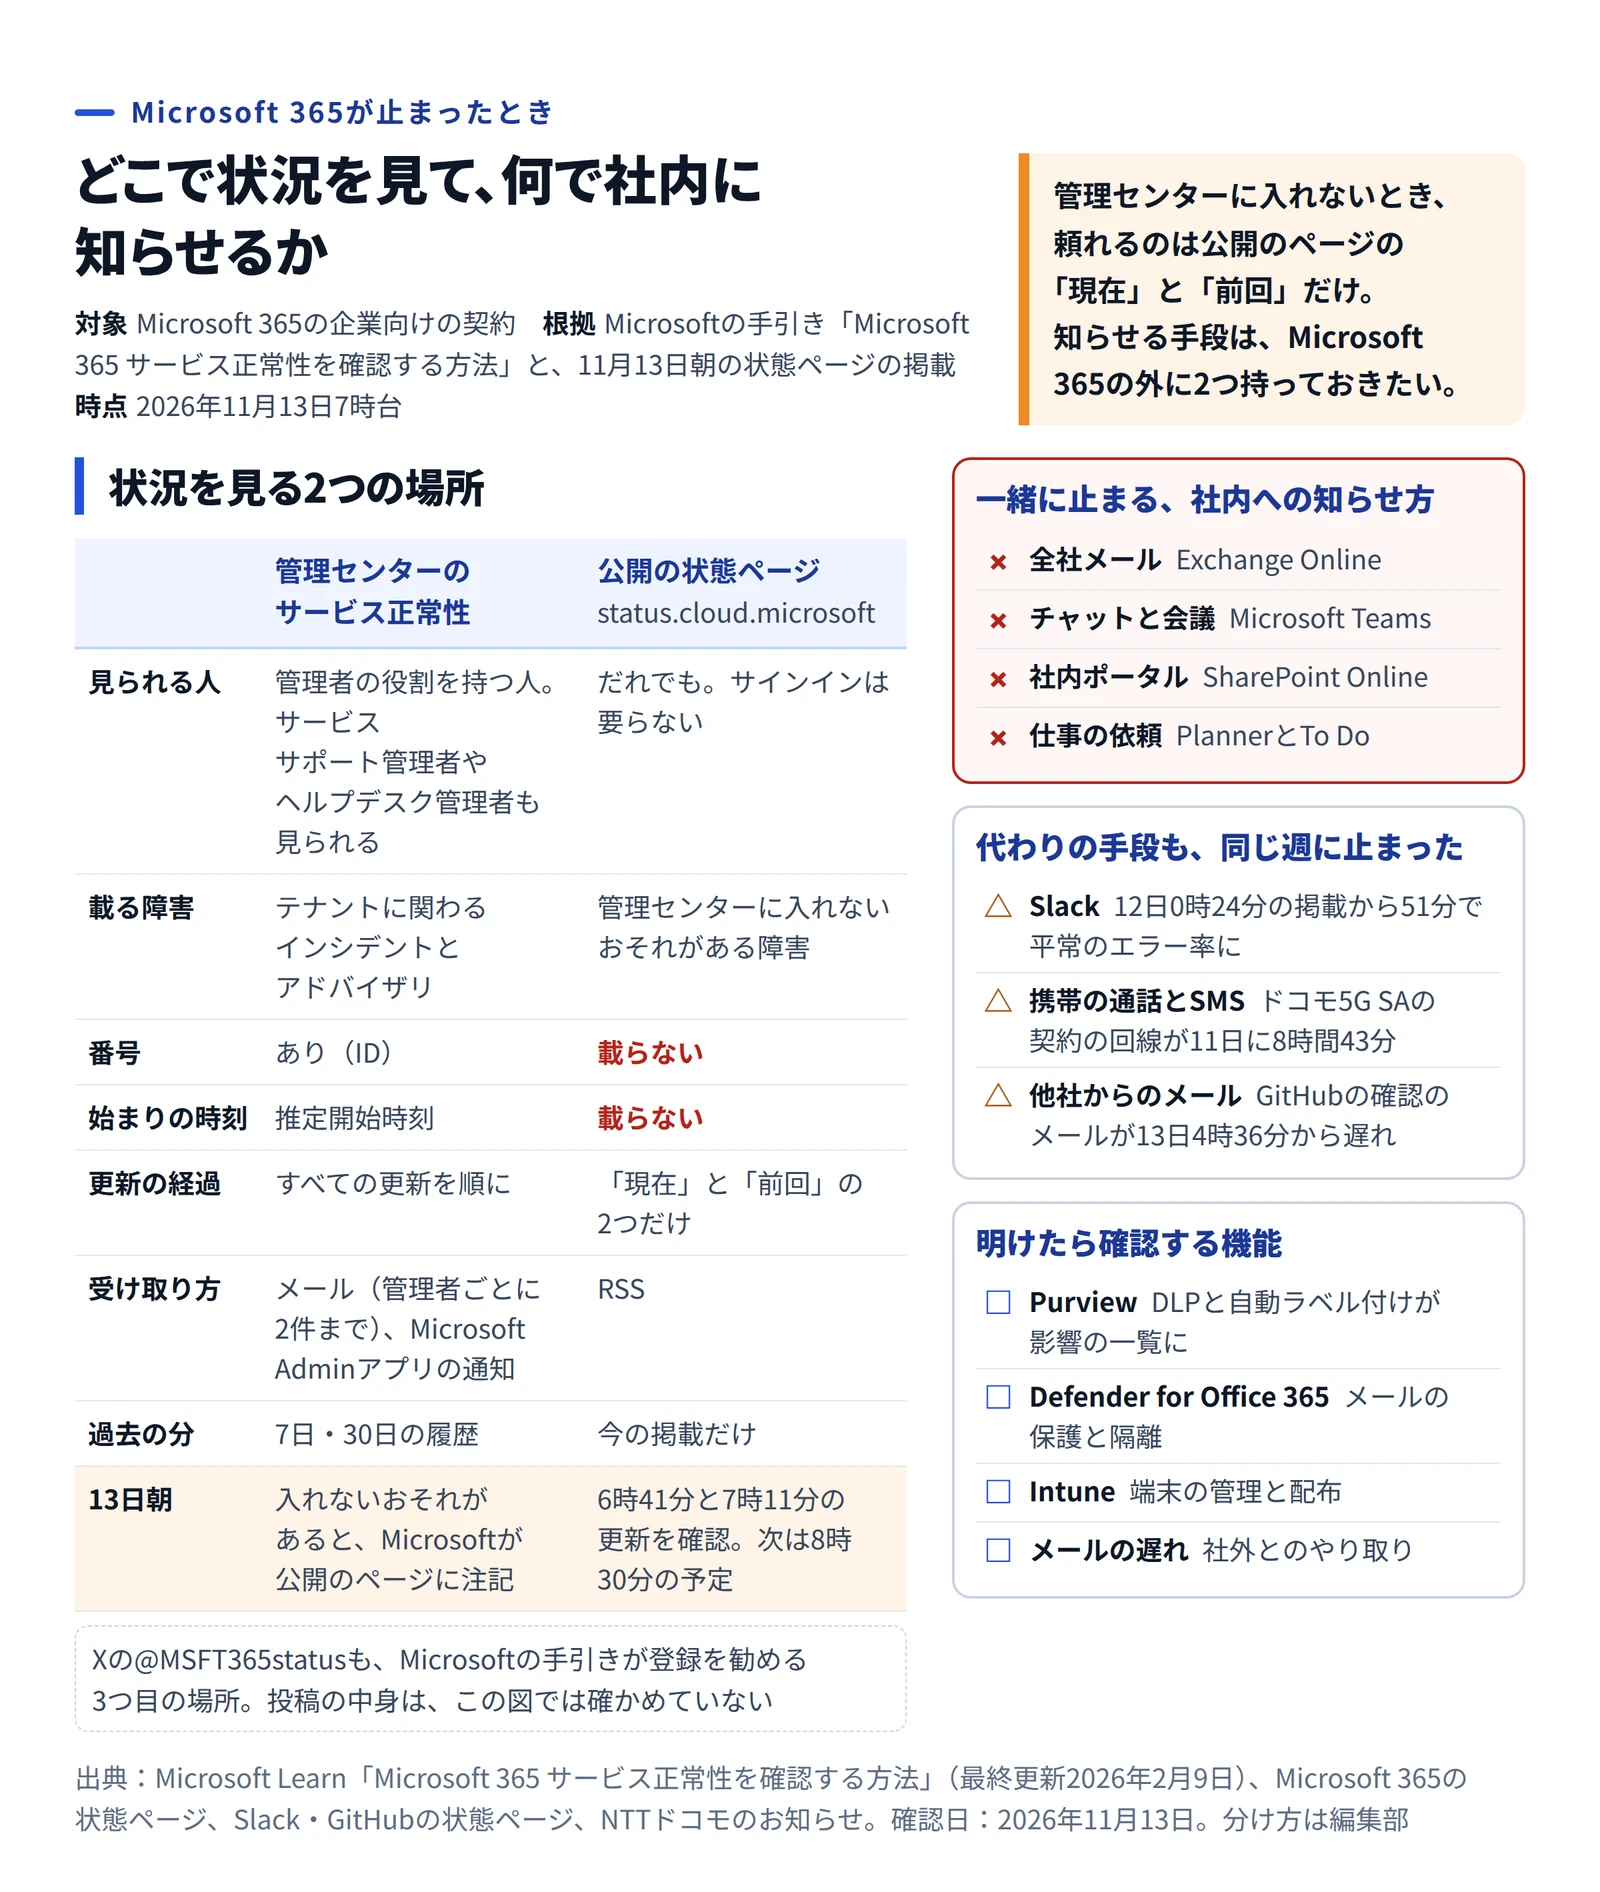
手引きの説明と今回の掲載を同じ項目でそろえると、違いは次の表のとおりです。
項目
管理センターのサービス正常性
公開の状態ページ
見られる人
管理者の役割が割り当てられた人(サービス サポート管理者とヘルプデスク管理者を含む)
だれでも。サインインは要らない
載る障害
テナントに関わるインシデントとアドバイザリ
管理センターに入れないおそれがある障害
番号
あり
なし
始まりの時刻
推定開始時刻
なし
更新の経過
すべての更新
最新と、ひとつ前の状況の2つ
受け取り方
メール(管理者ごとに2件まで)とMicrosoft Adminアプリ
RSS
過去の分
7日と30日の履歴
今の掲載だけ
受け取り方の行に、落とし穴があります。サービス正常性のメール通知は、管理者ごとに2つのアドレスまで登録できます。2つともExchange Onlineのメールボックスなら、今回のようにExchange Onlineが止まった障害の知らせは、管理者の手元に届かないおそれがあります。
一方、公開のページはだれでも開けますが、番号と始まりの時刻がなく、経過も2つ分しか残りません。社内の障害記録を残すときや、契約で約束された稼働率を確かめるときには、管理センターの番号と推定開始時刻が役立ちます。つまり、障害の最中は公開のページで状況を追い、明けたら管理センターで記録を控える順番になるでしょう。
Microsoft 365が止まったときに状況を見る場所と、社内への知らせ方 作成: 編集部 / 出典: Microsoftの手引きと各社の公式ページをもとに編集部が作成 代わりの連絡手段も、同じ週に止まっていた
Microsoft 365の代わりといえば、別の会社のチャットか、携帯の電話とSMSでしょう。ところが、その両方がこの4日間に止まっていました。
Slackの掲載によると、12日0時24分に調査を始め、0時51分ごろからエラーが減り、1時15分に平常のエラー率へ戻りました。読み込みや設定の保存のほか、ログインやチャンネルの作成、ワークフローの公開ができない利用者もいたそうです。Slackは、直近のデータベースの変更が引き金になった容量の問題とみて、原因を調べています。
ドコモでは11日10時34分から19時17分まで、5G SAを契約した回線で通話とデータ通信、SMSが使いにくくなりました。原因は、5G SAの契約者を収容する交換機の輻輳です。4Gや、5G SAを契約していない5Gの回線は影響を受けていません。どの社用携帯が対象かの見分け方は、ドコモ5G SAの障害、完全復旧まで8時間43分 社用携帯は契約を確認 が詳しく扱っています。
13日の朝は、Microsoftにつなぐ他社の機能も低下しました。Zoomは4時24分、Microsoftとの連携の障害を掲載し、Zoom MailのSchedulerやOneDriveのアプリ、カレンダーとアドインを対象に挙げています。原因は「ベンダー側の問題」とだけあり、社名は出ていません。
同じ時間帯には、GitHubでも4時36分から6時43分まで、サインインや確認のメールが届かない障害がありました。GitHubは上流のメール事業者の低下と説明しましたが、事業者の名前も、Microsoft 365との関係も書いていません。
代わりの手段を1つだけ決めておくと、それが同じ週に止まることもあります。2つ持つなら、運営する会社も通る回線も違うものを選ぶと安心です。社用携帯が全部同じ会社の同じ契約なら、連絡網は2本ではなく1本と考えたほうがよいでしょう。
最初に送る文も、Microsoft 365の外に置いておくと迷いません。たとえば「Microsoft 365のメールとTeamsに障害が出ています。急ぎの連絡は電話で。次の知らせは9時に送ります」の3文です。次の知らせの時刻を入れておけば、問い合わせが情シスに集まりにくくなるはずです。
Microsoft 365を使っていなくても影響する会社
AWSの東京リージョンでは、11日23時46分から12日5時31分まで障害が続きました。AWSによると、主にapne1-az1で起き、EC2の起動の失敗のほか、ECSやEKS、ELB、NAT Gatewayにも及びました。ネットワークの設定を変えていない既存のインスタンスへの接続や、インスタンスどうしの通信には影響がなかったそうです。ただ、12日1時40分の掲載では、ほかのアベイラビリティーゾーンでも少数の起動の失敗が出ていました。
気をつけたい点は、apne1-az1がAZ IDだということです。AWSの説明では、東京リージョンは2025年11月より前に作ったアカウントの場合、ap-northeast-1aのような名前と実際の場所の対応が、アカウントごとに違います。自社のap-northeast-1aがapne1-az1とは限りません。EC2ダッシュボードのサービスヘルスか、AWS CLIのdescribe-availability-zonesでAZ IDを見てから、その時間の記録を探すのが確実です。
このほか、ZoomをMicrosoftのカレンダーやOneDriveとつないでいる会社と、影響を受けたメール事業者のアドレスでGitHubを使う社員にも、13日朝に影響が出ました。12日早朝のGitHub Actionsの低下で、6時の定期実行を見直す手順はGitHub Actionsが12日早朝に低下、6時の定期実行を確認 で読めます。
自社がMicrosoft 365を使っていなくても、手続きの相手先が止まることがあります。プライバシーマークを取っている会社では、JIPDECのPマークポータルサイトが、13日未明からのMicrosoft 365の障害で使えなくなりました。更新申請と事故等の報告が影響を受け、JIPDECは、期限までに手続きできない場合は復旧後でよいとしています。ただし、個人情報保護委員会への漏えい等の報告の期限は、この案内で延びるものではありません。報告の順番は、アットホームの賃貸管理システムの記事 で読めます。
反対に、4Gの社用携帯や5G SAを付けていない回線、GMOあおぞらネット銀行の銀行APIを使っていない会社は、それぞれの障害の対象外でした。銀行APIの2回の停止と夜間の自動処理の確認は、GMOあおぞらの銀行APIが一晩に2回停止 にまとまっています。
障害が明けた朝に確認すること
管理センターのサービス正常性を開き、今回の障害の番号と推定開始時刻、影響を受けたサービスを社内の障害記録に写します。公開のページには、この3つがそろって残りません。
社外とのメールに、遅れや届いていないものがないかを見ます。GitHubのように確認のメールが届かず、サインインできなかった社員がいないかも聞いておきます。
Purviewの画面で、障害の時間に作られたファイルや送られたメールに、ラベルとDLPの判定が付いたかを確認します。
AWSの東京リージョンを使っているなら、AZ IDでapne1-az1の環境を見つけ、ほかのAZも含めて、11日23時46分から12日5時31分に失敗したAPIの呼び出しやワークフローを再実行します。AWSも、失敗したものの再試行を勧めています。
サービス正常性のメール通知の宛先を見直します。2つのうち1つをMicrosoft 365の外で受けられるアドレスにしておけば、次にExchange Onlineが止まっても、知らせを受け取れる見込みが残ります。
止まったツールで、止まったことを知らせようとする。障害の朝にいちばん困る場面です。知らせる手段と状況を見る場所を、止まるものとは別の会社に1つずつ。それを決めておくだけで、次の朝の段取りはずいぶん変わるはずです。
各社の掲載は、2026年11月13日7時台の内容です(Microsoft 365は14日7時の掲載まで)。
2026年11月13日 更新:Microsoft 365の8時6分の掲載(影響を受けたサーバーの一部を戻し、一部の地域で限られた回復)を書き足しました。
2026年11月14日 更新:Microsoft 365の14日7時の掲載(回復は続くが解決の扱いはまだ・影響はExchange Onlineとやり取りする機能で、Teamsの通話や会議は外れた)を書き足し、見出しと説明文を直しました。JIPDECのPマークポータルサイトが同じ障害で止まった件も足しました。