Googleは2026年10月22日、Knowledge Catalogで業務上の意味や定義を補う「自己学習型の文脈補強機能」をプレビューとして発表しました。Geminiが文書や対話から不足する説明を探し、データの定義などの更新を提案します。刷新したKnowledge Studioもプレビューとして発表し、新機能は今後数週間で顧客に順次提供する予定です。
文書とデータの定義を結び付け、更新案を提示
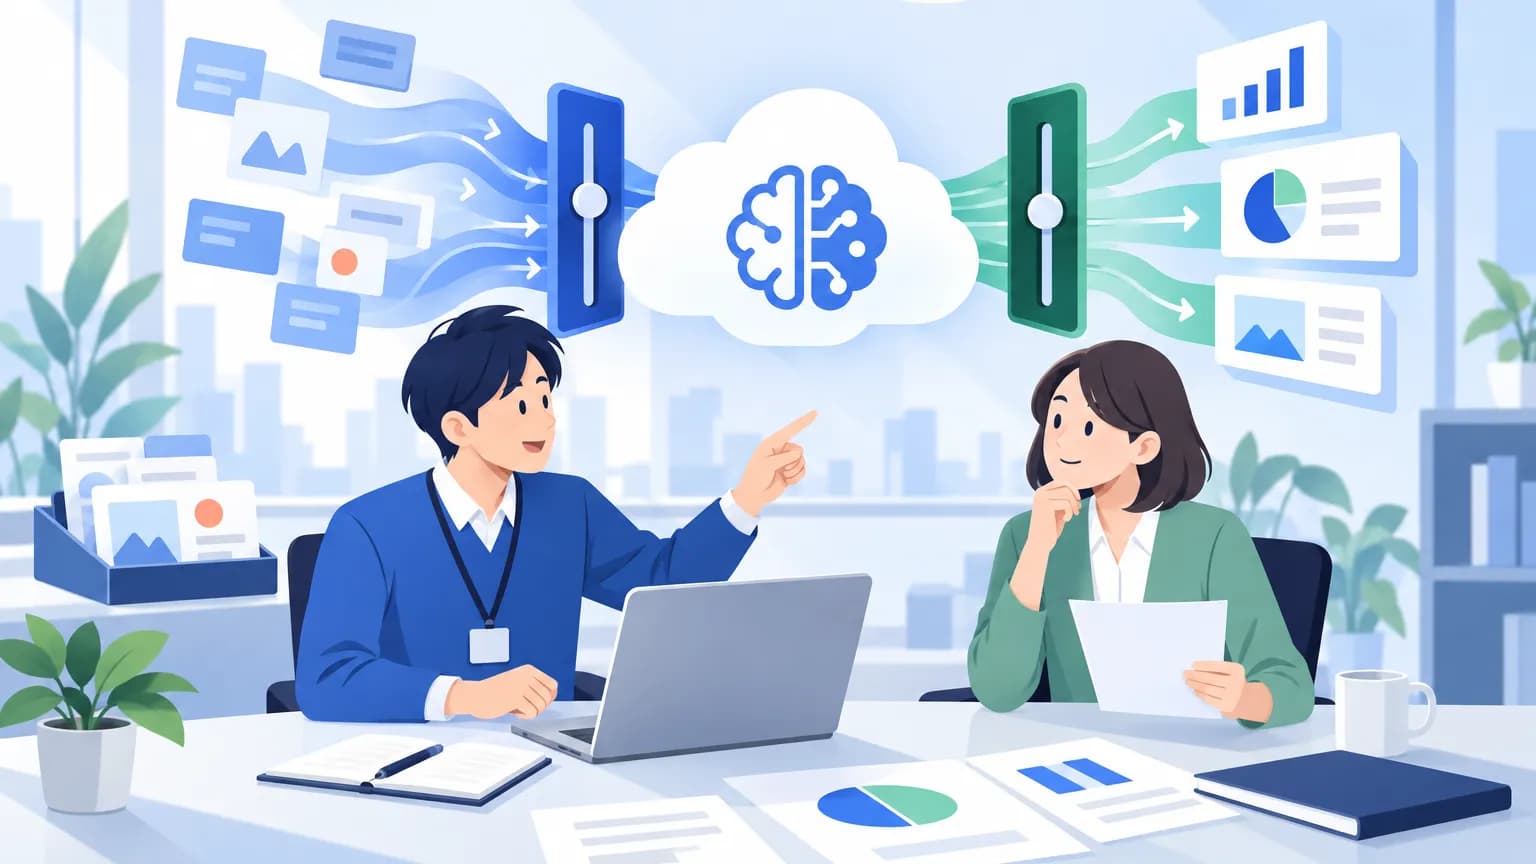
今回の機能は、データそのものだけでなく、その意味を説明する情報を整えるものです。Googleによると、GeminiがユーザーやAIエージェントとの対話から文脈の不足を探し、業務文書やコードの保管場所から定義を抽出します。
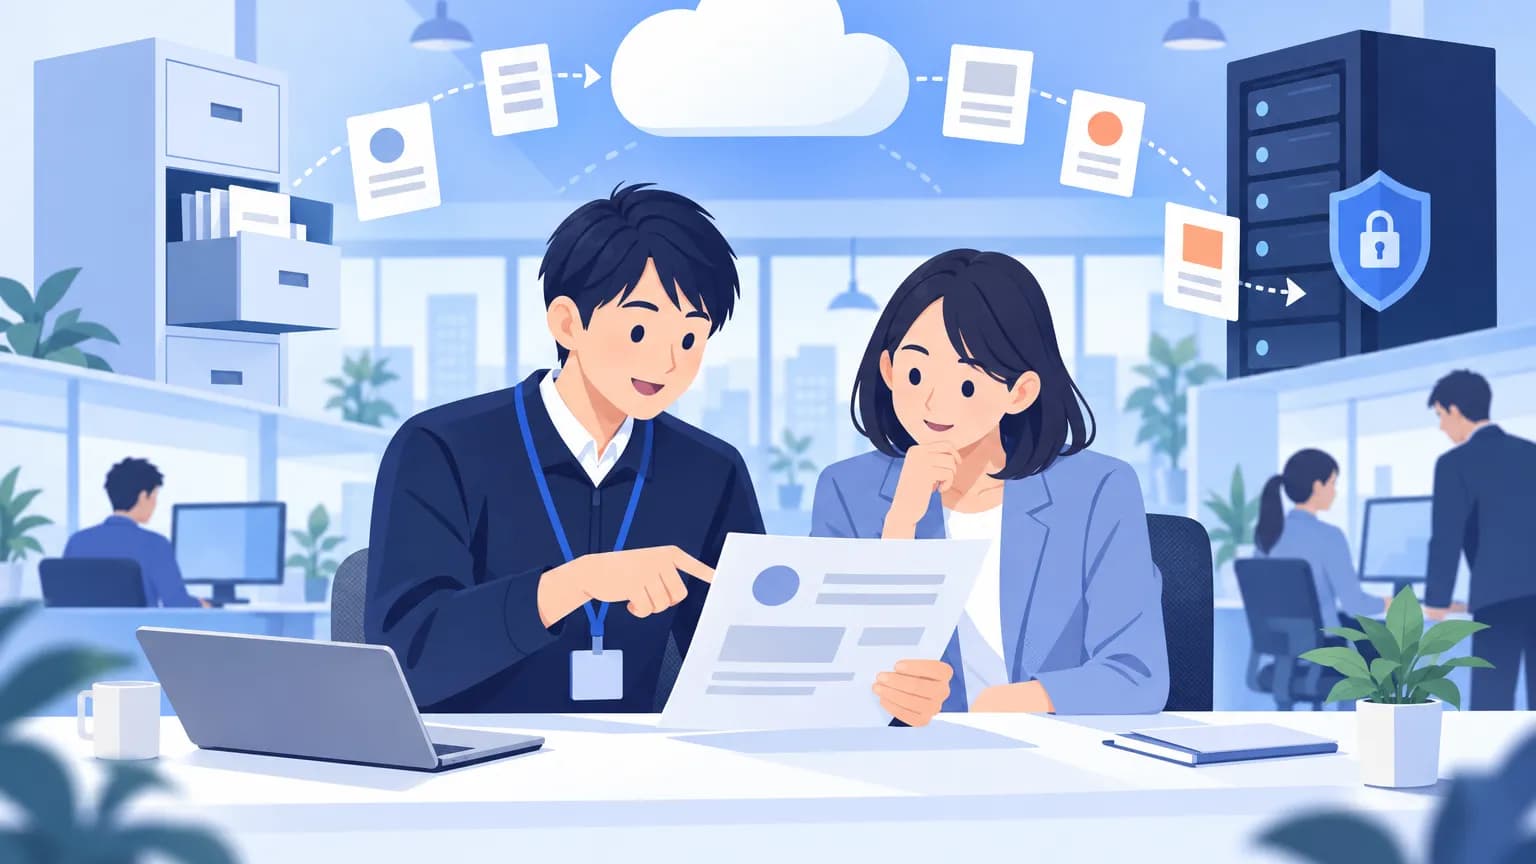
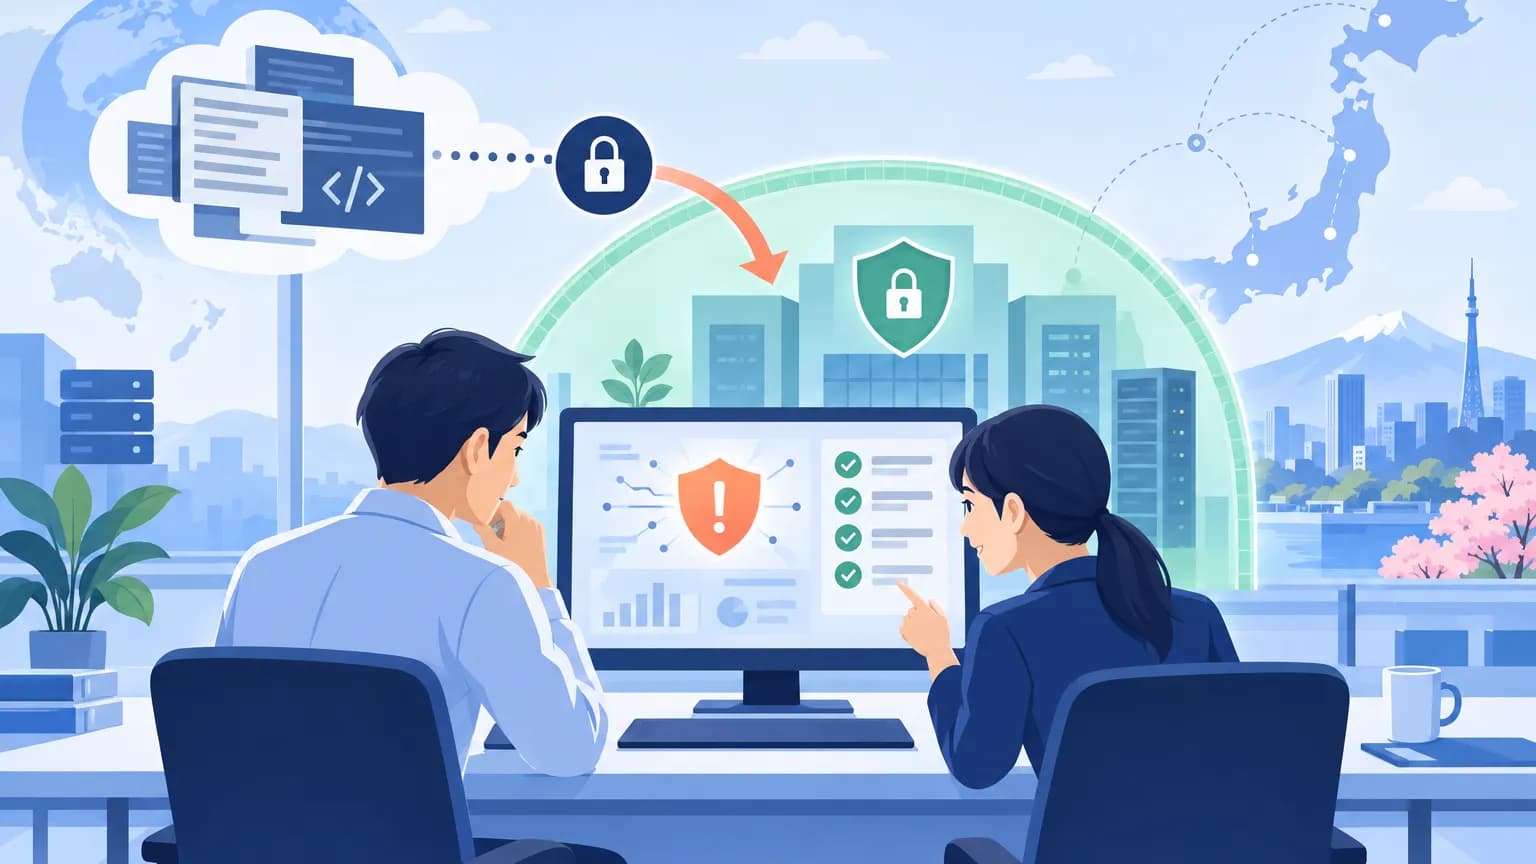
接続対象には、自社・他社の表形式のデータと、文書などの非構造化データが含まれます。Google Workspace、GitHub、Confluence、SharePoint、Cloud Storageなどに対応するとしています。文書やWikiの知識を、テーブルやデータ構造の説明情報であるメタデータに結び付けます。
提案する内容は、業務定義、列の説明、テーブル同士の結合関係などです。随時または定期的に提案し、それぞれに出典と信頼度スコアを付けます。更新元の変更も検知し、古い定義を廃止して、矛盾する内容をレビューに回すとしています。
重要なのは、単に説明文を生成するだけでなく、変更後の確認や承認まで扱う点です。資料の接続範囲と、定義の更新を誰が認めるかをセットで考える必要があります。
自動公開の設定と、人による承認を使い分ける
自動公開の有効・無効に加え、変更を自動承認する信頼度の基準値を設定できます。基準値に満たない提案や削除などは、管理担当者が承認・編集・却下します。独自の評価セットによる更新案のテスト、変更履歴の記録、差し戻しも可能です。
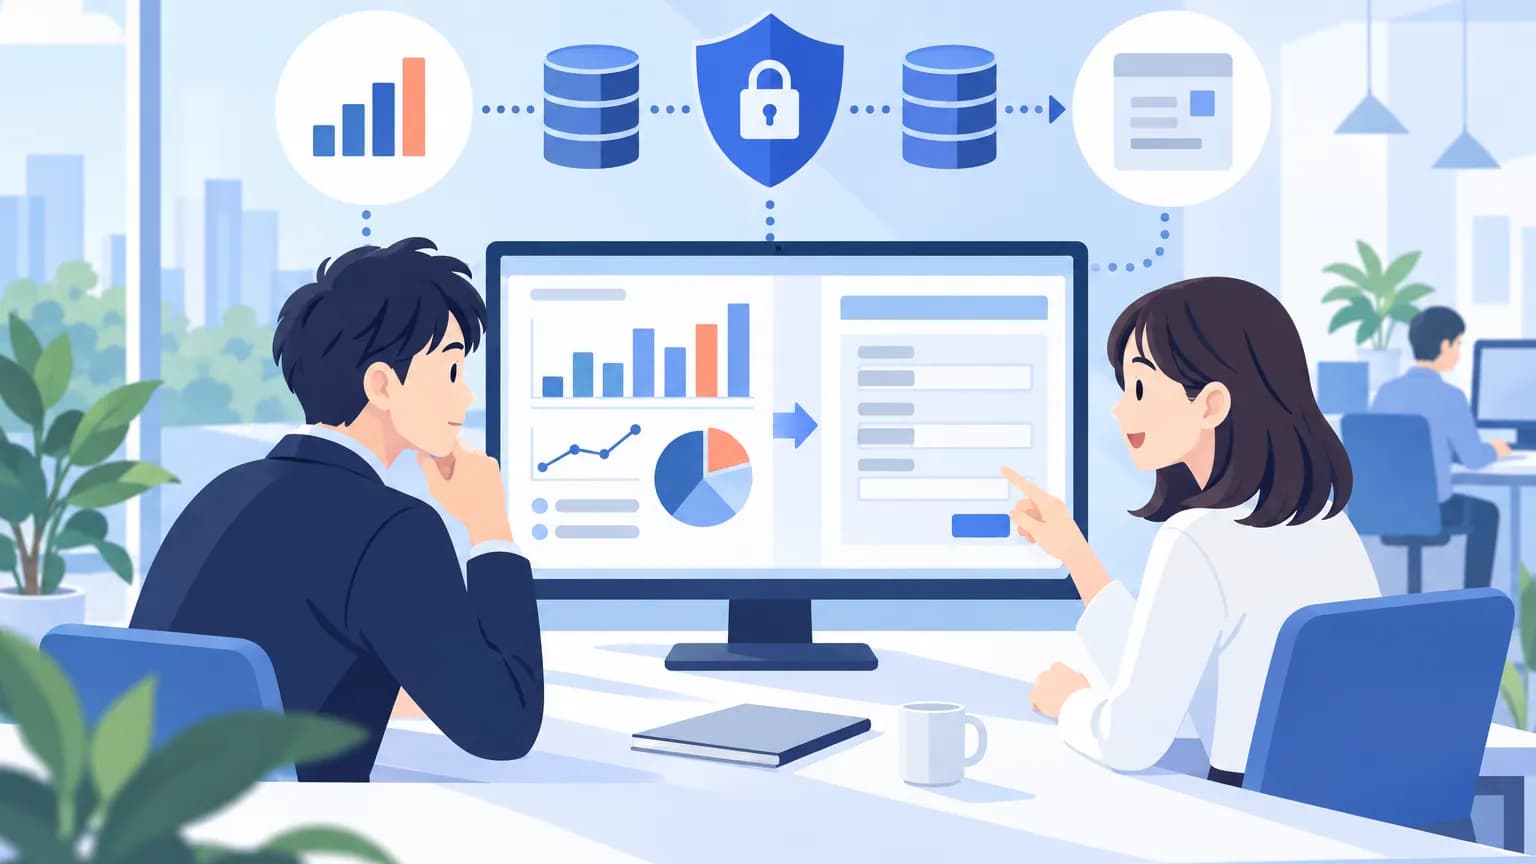
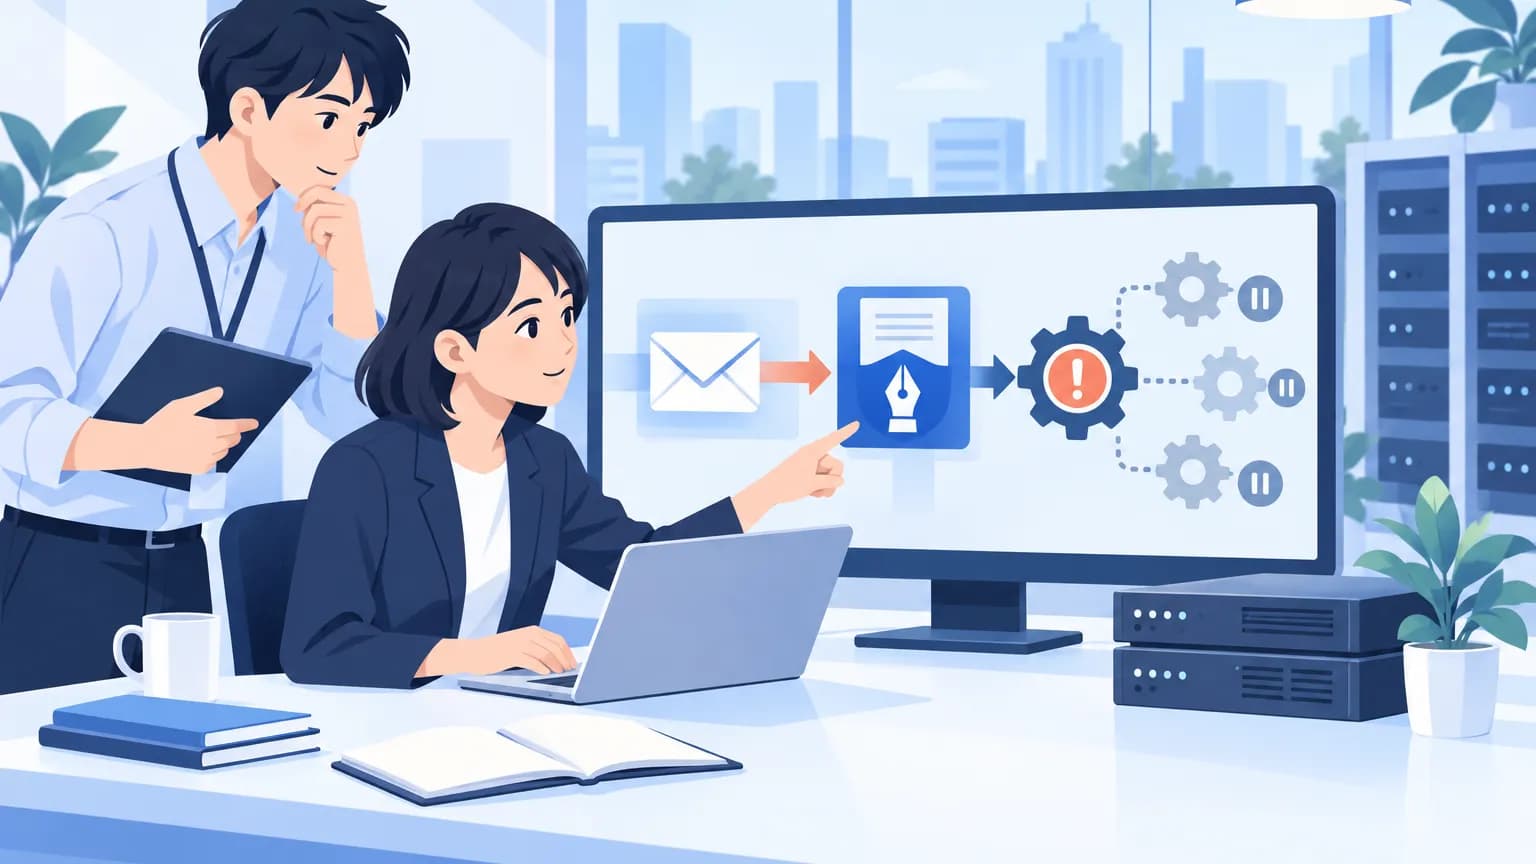
Knowledge Studioでは、文脈のつながりを可視化し、自然言語で探索できます。変更案の確認、承認、差し戻しにも対応します。補強処理の結果や、AIが処理する文章量の単位であるトークンの使用量、実行時間を監視し、完了をメールで通知する機能もあります。
部門や用途ごとの定義・指標は「context sets」にまとめられます。アクセス権はIAMという権限管理の仕組みで制御し、元データの既存権限も維持するとしています。
対話履歴は、個人識別情報をマスキングして分析する設定が可能です。自作エージェントやBigQueryのConversational Analyticsも分析対象になります。一方、Googleは顧客データをモデルの学習には使わないとしています。対話から定義を補う処理と、モデル自体の学習は分けて捉える必要があります。
即時アクセスの申請も受け付けますが、全顧客が直ちに使えるという発表ではありません。日本での提供は発表には書かれていません。日本語対応、日本の料金、利用できるリージョンも記載されていません。
影響する会社・しない会社
- 影響する: Knowledge Catalogの新機能を試す会社です。自動公開の可否、承認の基準値、変更を確認する担当者を検討する必要があります。
- 影響する: Google WorkspaceやGitHub、Confluence、SharePointなどを接続対象にする会社です。どの文書やコードを業務定義の根拠にするかが確認事項になります。
- 影響しない: Knowledge Catalogを使わず、今回のプレビューも試さない会社には、本機能を設定する直接の作業はありません。既存サービス全般への強制適用は発表には書かれていません。