Google Cloud の米国中部のリージョン「us-central1」(アイオワ)で、日本時間2026年9月1日の深夜から約4時間、仮想サーバーやデータベース など16の製品で、通信が途切れたりエラーが増えたりする障害 が起きました。Google は事後の障害報告で、原因はデータセンターの保守作業の手順の誤りだったと公表しています。同じus-central1では、10月8日〜10日にもCloud Storageの障害が続きました。この記事は、Googleの公式の状況ページと文書で確かめた範囲を書きます。
公式の資料で確かめられたこと
項目
内容
題
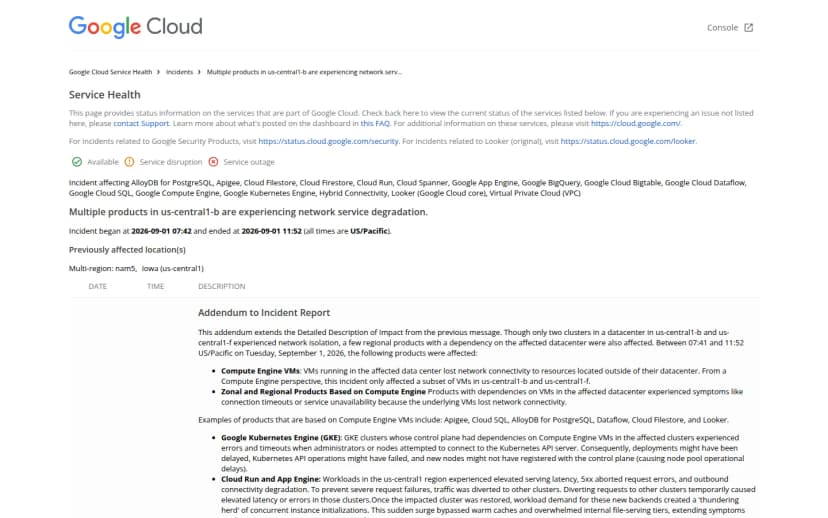
Multiple products in us-central1-b are experiencing network service degradation.
時間(日本時間)
9月1日23時41分〜9月2日3時52分。4時間11分(障害報告の記載。米国太平洋時間では9月1日7時41分〜11時52分。状況ページの表示は7時42分から)
場所
us-central1-bとus-central1-fの一部(1つのデータセンターの2つのクラスタ)。状況ページの表示は「Iowa (us-central1)」と、マルチリージョンの「nam5」
区分
Service disruption(サービスの障害)。重さは medium
影響した製品
Compute Engine、GKE、Cloud Run、App Engine、Cloud SQL、AlloyDB for PostgreSQL 、Cloud Spanner、Cloud Firestore、Cloud Bigtable、BigQuery、Dataflow、Cloud Filestore、Apigee、Looker、VPC、Hybrid Connectivityの16製品
原因
ルーターの保守作業で、すべての光ファイバーの経路が13分のうちに抜かれた
事後の報告
9月4日に速報、9月11日に障害報告、9月30日に追記(いずれも日本時間)
Google Cloudの状況ページの9月1日の障害の項目(表示の時刻は米国太平洋時間) 出典: Google Cloud「Google Cloud Service Health」 (引用) ピークの時間は、対象の資源への通信が100%落ち、仮想サーバーに外から届かず、外へもつながらなくなりました。
経過(日本時間)
9月1日23時41分: 対象のクラスタで通信が途切れる
23時45分と0時0分: 通信をほかの設備へ逃がす
9月2日0時50分: 物理的な接続の大部分が戻る
1時3分: 状況ページに初めて掲載(始まりから1時間22分後)
1時15分: GKEの管理の窓口(Kubernetes APIサーバー)へのエラーが収まる
3時52分: ほぼすべての製品で回復を確認
状況ページのデータでは、9月30日の追記は10月18日(日本時間)に最後の更新があります。何を直したかは書かれていません。
原因は保守作業の手順の誤り
障害報告によると、技術者が、データセンターのルーターで計画どおりの容量の増強をしていました。光ファイバーを抜き、光の送受信の部品を新しいものに取り替える作業です。新しい部品は残っていた古い部品と組み合わせて使えず、抜いた経路ごとに接続が失われました。
ルーターは同じ建物の別の部屋に分けて置かれ、作業も数日かけて1台ずつ、つながりを確かめながら進める計画でした。しかし、手作業で組んだ段取りに誤りがあり、すべてのルーターの交換の一覧が、1台ずつ進める指示のないまま渡されました。思わぬ切断に気づくための人とソフトウェアの確認もありませんでした。
その結果、13分のうちにすべての経路が順に抜かれました。抜いたファイバーに光が通っていたら止める、という決まりも守られなかったとしています。
Googleは、再発を防ぐために次の4つを進めるとしています。
保守の手順の教育をやり直し、抜いたファイバーに光が通っていないかの確認を必須にする
ネットワークの増強の作業を、自動で順番を守る仕組みに移す(ゾーンの作業を移している途中)
使用中のファイバーが抜かれたら、作業を止める知らせを出す
不調のゾーンから自動で通信を逃がし、今回の約19分を約5分に縮める
初報より広かった影響
当日の更新は、どれも「us-central1-bの一部で起きている。リージョンのほかのゾーンは影響を受けていない」と書いていました。事後の障害報告と追記では、影響はもっと広く書かれています。
us-central1-fの一部も、通信が途切れた
複数のゾーンにまたがる「リージョン」の製品も、0時0分まで影響を受けた。Cloud RunとApp Engineは、処理を移した先でも遅れやエラーが出て、一部は3時52分まで不調が続いた
us-central1を含むマルチリージョンのnam5で、Cloud SpannerとCloud Firestoreのエラーや書き込みの時間切れが増えた
us-central1のCloud VPNの一部が落ちた。us-central1のCloud Interconnectを通る通信は、どのリージョンの資源でも、条件によっては途切れた
us-central1の一部の負荷分散とSecure Web Proxyで、遅れや接続の問題が出た
一方で、us-central1のほかのゾーンにも分けて置き、正しく切り替わる構成は、大部分が影響を避けて動き続けたとしています。us-central1-bとus-central1-fの両方に置いていた利用者も、影響を受けたのは多くてもどちらか一方のゾーンだけだったと書かれています。当日の回避策として、Googleは、処理の再試行と、ほかのゾーンへの切り替えを挙げていました。
Googleの文書は、ゾーンを「リージョンの中の1つの故障の単位」として扱うよう書いています。止まると困るシステムは、1つのリージョンの複数のゾーンに分けて置くよう勧めています。
同じus-central1で10月にもCloud Storageの障害
同じus-central1では、10月にもCloud Storageの障害がありました。日本時間10月8日20時0分〜10月9日8時30分(12時間30分)に、アップロードや書き込みの遅れとエラーが続きました。さらに10月9日20時5分〜10月10日1時46分(5時間41分)に、us-central1-bのゾーンで再発しています。合わせて18時間11分です。
10月14日の障害報告では、負荷分散の設定の変更で、容量の少ない一部の保存の設備に書き込みが集中したことが原因でした。再発は、別の機能を元に戻す作業が不完全だったためとしています。9月とは原因が違いますが、同じリージョンで2か月続けて業務に響く障害が起きました。10月前半のほかの障害は、クラウド・SaaSの障害11件を図解 10月前半に止まったものと代わりの手段 にまとめています。
影響する会社・しない会社
影響する: us-central1-bかus-central1-fの1つのゾーンだけに、仮想サーバーやCloud SQLなどを置いていた会社。9月1日の深夜(日本時間)に、つながらない時間がありました。
影響する: us-central1のCloud Run、App Engine、GKE、リージョンの負荷分散、Cloud VPNと、nam5のCloud Spanner・Cloud Firestoreを使っていた会社。遅れやエラーが出ました。
影響する(確認が要る): PSCでus-central1のサービスにつなぐ会社と、us-central1のCloud Interconnectを通る会社。どのリージョンからでも影響があり得たとされています。
影響する(確認が要る): 使っているSaaSや委託先のシステムがus-central1で動いている会社。自社で契約していなくても止まることがあります(編集部の補足)。
影響しない: us-central1とnam5のどちらも使わず、us-central1につながるPSCやInterconnectも無い会社。
情シスが今日やること
使っているリージョンとゾーンを一覧にする : 仮想サーバー、データベース、GKEのクラスタが、どのリージョンのどのゾーンにあるかを書き出し、1つのゾーンにしか無いものに印を付けます。止まると困るものを複数のゾーンへ : 印を付けたもののうち業務が止まるものは、ほかのゾーンにも置けるかを、担当者や委託先と相談します。費用と切り替えの時間も見ます。SaaSと委託先に、動いている場所を聞く : Google Cloudのどのリージョンで動いているか、9月1日と10月8〜10日に影響があったか、ゾーンが止まったらどう切り替わるかを、文書で返してもらいます。障害の知らせを担当者に届ける : Personalized Service Healthで、自社のプロジェクトに関係する障害のアラートを設定します。今回、状況ページへの掲載は始まりから1時間22分後でした。自社のサービスを外から見る死活監視も持ちます。自社の影響を記録に残す : 止まった時間と業務、再試行で戻ったかを、障害報告と並べて記録します。止まった時間の重さは業務停止の損失シミュレーター でも見積もれます。
書かれていないこと
影響を受けた利用者の数と割合、日本の利用者への影響、SLA(稼働率の保証)や返金の扱い、10月18日の更新で変わった点、9月と10月の障害のつながりは、確かめた資料に書かれていません。この記事でも書きません。