今朝6時0分のGitHub Actions の定期実行は、障害 のさなかに起動の時刻を迎えていました。GitHub の状況ページによると、日本時間11月12日の5時48分から6時21分にかけて、Actions、Pages、Webhooks、Copilot の性能や可用性が落ちました。
障害はすでに解消し、たまっていたActionsのジョブも6時21分までに処理を終えました。詳しい原因はまだ公表されておらず、分析がまとまり次第出すとのこと。その直前、5時22分からの4分間には、Webhooksだけの小さな障害もありました。
5時48分からの33分間
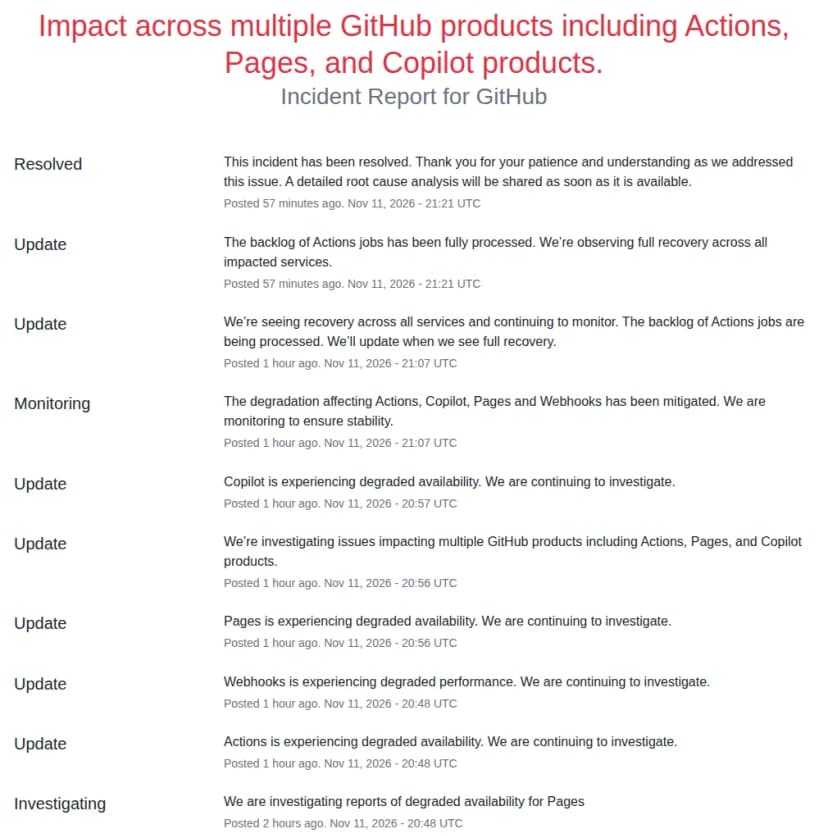
状況ページの記録を日本時間に直すと、次の流れです。
日本時間
状況ページの記録
5時48分
Pagesの可用性の低下を調べ始めた。Actionsの可用性とWebhooksの性能も低下
5時56分
Pagesの可用性が低下。Actions、Pages、Copilotなど複数の製品に影響
5時57分
Copilotの可用性も低下
6時07分
低下は抑えた。たまったActionsのジョブを処理している
6時21分
ジョブを処理し終え、すべてのサービスが回復した
GitHubの状況ページの、11月11日(協定世界時)の障害の記録 出典: GitHub, Inc. (引用) 状況ページは影響の大きさを、いちばん重い「critical」としました。時間は33分と短めですが、朝6時ちょうどをまたぎました。
ただし、5時48分は状況ページで調べ始めた時刻で、影響の始まりとは限りません。原因の報告が出た前の3回のうち2回では、影響の始まりが最初の投稿より16〜25分早く、今回も5時台の前半から影響が出ていたかもしれません。
早朝に何も動かしていなければ、影響しない
日本時間の5時20分ごろから6時21分にかけて、Actionsでテスト やデプロイ、定期の処理を動かしていた会社が、まず当てはまります。Pagesで社内の資料やサイトを公開している会社は、その時間のデプロイが遅れた可能性があります。WebhookでGitHubとチャットやチケットの管理、デプロイの仕組みをつないでいる会社なら、5時22分からの4分間の障害も見ておく範囲です。
その時間に何も動かしていなかった会社なら、気にしなくてよいでしょう。GitのpushやPull Requestの操作は今回の記録の対象外でした。
3週間あまりで5回、同じ3つがそろって遅れた
状況ページで影響を受けた製品の欄にActions、Pages、Webhooksの3つがそろった障害は、10月20日から数えて今回で5回目です。1
日本時間
原因の報告の要点
報告にある影響
10月20日の0時24分〜1時52分
Actionsのログや状態を持つ社内のサービスが、キャッシュへの接続を全台から一斉につなぎ直し、共有の回線があふれた
ホステッドランナーのジョブの5.13%で開始が遅れ、実行の0.02%が失敗。データは失われていない
10月31日の2時50分〜4時23分
ネットワークの保守をきっかけに、Redisへの接続を激しくつなぎ直した。接続の約90%が失敗
ワークフローの処理、Pagesのデプロイ、Webhookの配信が遅れた
11月5日の0時49分〜1時48分と2時20分〜2時55分
イベントを振り分ける社内のサービスの設定変更で、イベントの流れが止まった
Actionsの実行が最大25分遅れ、Pagesのデプロイは通常の約4%、Webhookの配信は約58%に落ちた
11月10日の3時12分〜3時59分
まだ出ていない
ActionsとChecks APIのエラーが増え、PagesとWebhooksも低下
11月12日の5時48分〜6時21分
まだ出ていない
たまったジョブは6時21分までに処理
しかも5回とも、日本の深夜から早朝に当たっていました。夜間の集計や朝のレポートを流す時間帯と、ちょうど重なります。
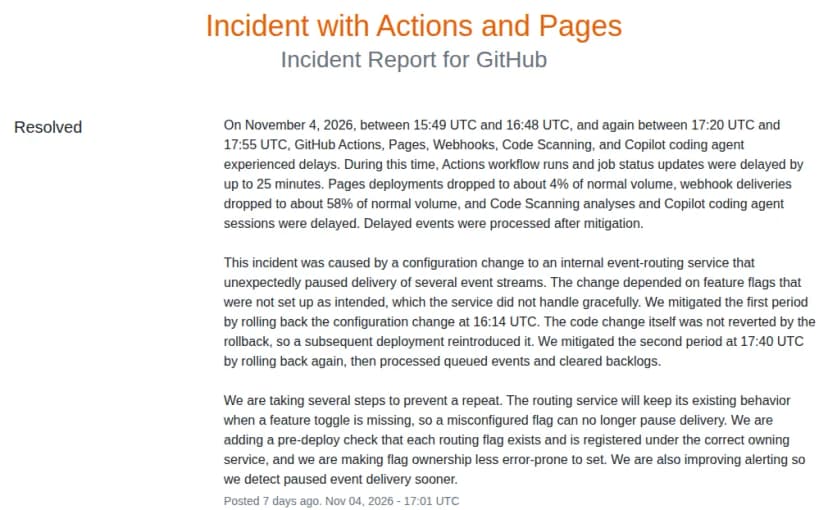
11月4日(協定世界時)の障害の、GitHubによる原因の報告 出典: GitHub, Inc. (引用) 10月20日の報告で遅れたのは、Actionsの実行から出るPagesのデプロイとWebhookでした。11月5日は、イベントを振り分ける社内のサービスが止まり、3つがまとめて遅れました。PagesとWebhookの一部はActionsやイベントの流れの後ろにつながっていて、そこがつまずくと一緒に遅れる、とみています。
もっとも、3つがそろうことと障害の重さは別の話です。10月6日(日本時間)の障害はActionsとPagesだけでしたが、もっとも重い約90分には、ホステッドランナーを使う実行の47.0%が失敗しました。
6時ちょうどの定期実行は、落とされることがある
ただ、scheduleで動くワークフローには、気をつけたい性質があります。GitHubのドキュメントによれば、Actionsが混み合うと遅れることがあり、混む時間には毎時0分も入ります。負荷が十分に高いと、待ち行列のジョブが「may be dropped」、つまり落とされることもある、という書き方です。
scheduleのcronは既定で協定世界時に従います。日本時間の6時は協定世界時の21時なので、0 21 * * *と書いたワークフローは、ちょうど障害のさなかに起動するはずでした。timezoneにAsia/Tokyoを指定して0 6 * * *と書いた場合も同じです。
GitHubによれば、たまったジョブは処理し終えました。多くは遅れて動いたはずですが、scheduleの回が落ちなかったかまでは書いていません。
遅れて動いた回なら記録が残るので、見つけやすい。落とされたなら、その回の実行が一覧に現れない形になるかもしれません。失敗の一覧を眺めるだけでは見落とす種類の影響、というわけです。
遅れを減らす手として、同じドキュメントは毎時0分を外した時刻に入れることを勧めます。夜間の集計や朝のレポートを0分ちょうどに置いている会社は、何分かずらす価値があります。
今朝の実行を確認する手順
scheduleで動くワークフローの実行の一覧を見て、6時前後の回があるかを確認します。Actionsの画面で「Event」の絞り込みにscheduleを選ぶか、gh run list --repo <組織>/<リポジトリ> --event schedule --limit 20で一覧にできます。
回が見当たらないワークフローでも、workflow_dispatchの起動が書かれていれば、Actionsの画面の「Run workflow」から手で動かせます。書かれていなければ、次の定時まで待つか、担当者と相談して同じ処理を手で回してください。
5時20分ごろから6時21分までに始まった実行も、遅れて動いたものを含めて結果を見ます。状況ページの最初の投稿より前に影響が始まっていた前例があるためです。失敗していれば再実行し、デプロイなら本番に新しい版が出ているかも確認。
Webhookの「Recent deliveries」で、5時台から6時台の配信に失敗がないかを見ます。GitHubは失敗した配信を自動では送り直さず、手で送り直せるのは3日以内です。画面の操作なら、10月20日の障害の記事 の手順がそのまま使えます。
Webhookの配信を急いで見たい理由は、もう1つあります。GitHubは受け側が10秒以内に応答しない配信を、失敗として記録します。遅れていた配信がまとめて届いた時間帯は、受け側の処理が追いつかず、失敗が増えていることもありえます。
Actionsの結果をWebhookでチャットに流している仕組みは、Actionsがつまずく朝ほど知らせも遅れます。知らせが来ないことを「問題なし」と読まない。12日の原因の報告が出たら、前の回と同じ経路の話かどうか、見比べておきたいところです。