本文へ移動
情シスのミカタ
ニュース約3分で読めます

Azure、VMSSのゾーン自動分散を正式提供 可用性維持

Microsoftが、複数の可用性ゾーンにまたがる仮想マシンスケールセット(VMSS)で、ゾーン間のインスタンスの偏りを自動で均等化する機能を正式提供(GA)しました。ゾーン冗長が気づかぬうちに目減りするのを防ぎます。Azureで可用性を組む情シスが押さえるべき使いどころと注意点を整理します。

公開 情シスのミカタ編集部AIにより執筆チェック済み
文字
Azure、VMSSのゾーン自動分散を正式提供 可用性維持

この記事のまとめ

  • Microsoftが、複数の可用性ゾーンにまたがる仮想マシンスケールセット(VMSS)で、ゾーン間のインスタンスの偏りを自動で均等化する機能を正式提供(GA)しました。
  • ゾーンが偏ると、1つのゾーン障害で不釣り合いに多くのVMが落ちる恐れがあります。この機能は常時監視して平常時に偏りを均し、ゾーン冗長の前提を保ちます。
  • 既定は無効で、管理者が設定して有効化します。ステートレスが前提、均す間は一時的に容量が1台増える、ゾーン障害復旧の代替ではない、といった注意点があります。
こんな方に#20代#30代#40代#50代実務

クラウドで可用性を高めるために、複数の「可用性ゾーン」にサーバーを分散して置く構成は、一般的になりました。ところが、運用のなかでゾーン間の台数が偏ってしまい、「冗長を組んだつもりが、実質的な冗長性が目減りしていた」ということが起こりえます。Microsoftは、この偏りを自動で均す機能「Automatic zone balance for Virtual Machine Scale Sets(VMSSのゾーン自動分散)」を正式提供(GA)しました。

何が改善するのか

VMSS(仮想マシンスケールセット)は、同じ構成のVMをまとめて増減できる仕組みです。複数の可用性ゾーンにまたがって置くことで、1つのゾーンに障害が起きても、ほかのゾーンのVMで動き続けられます。

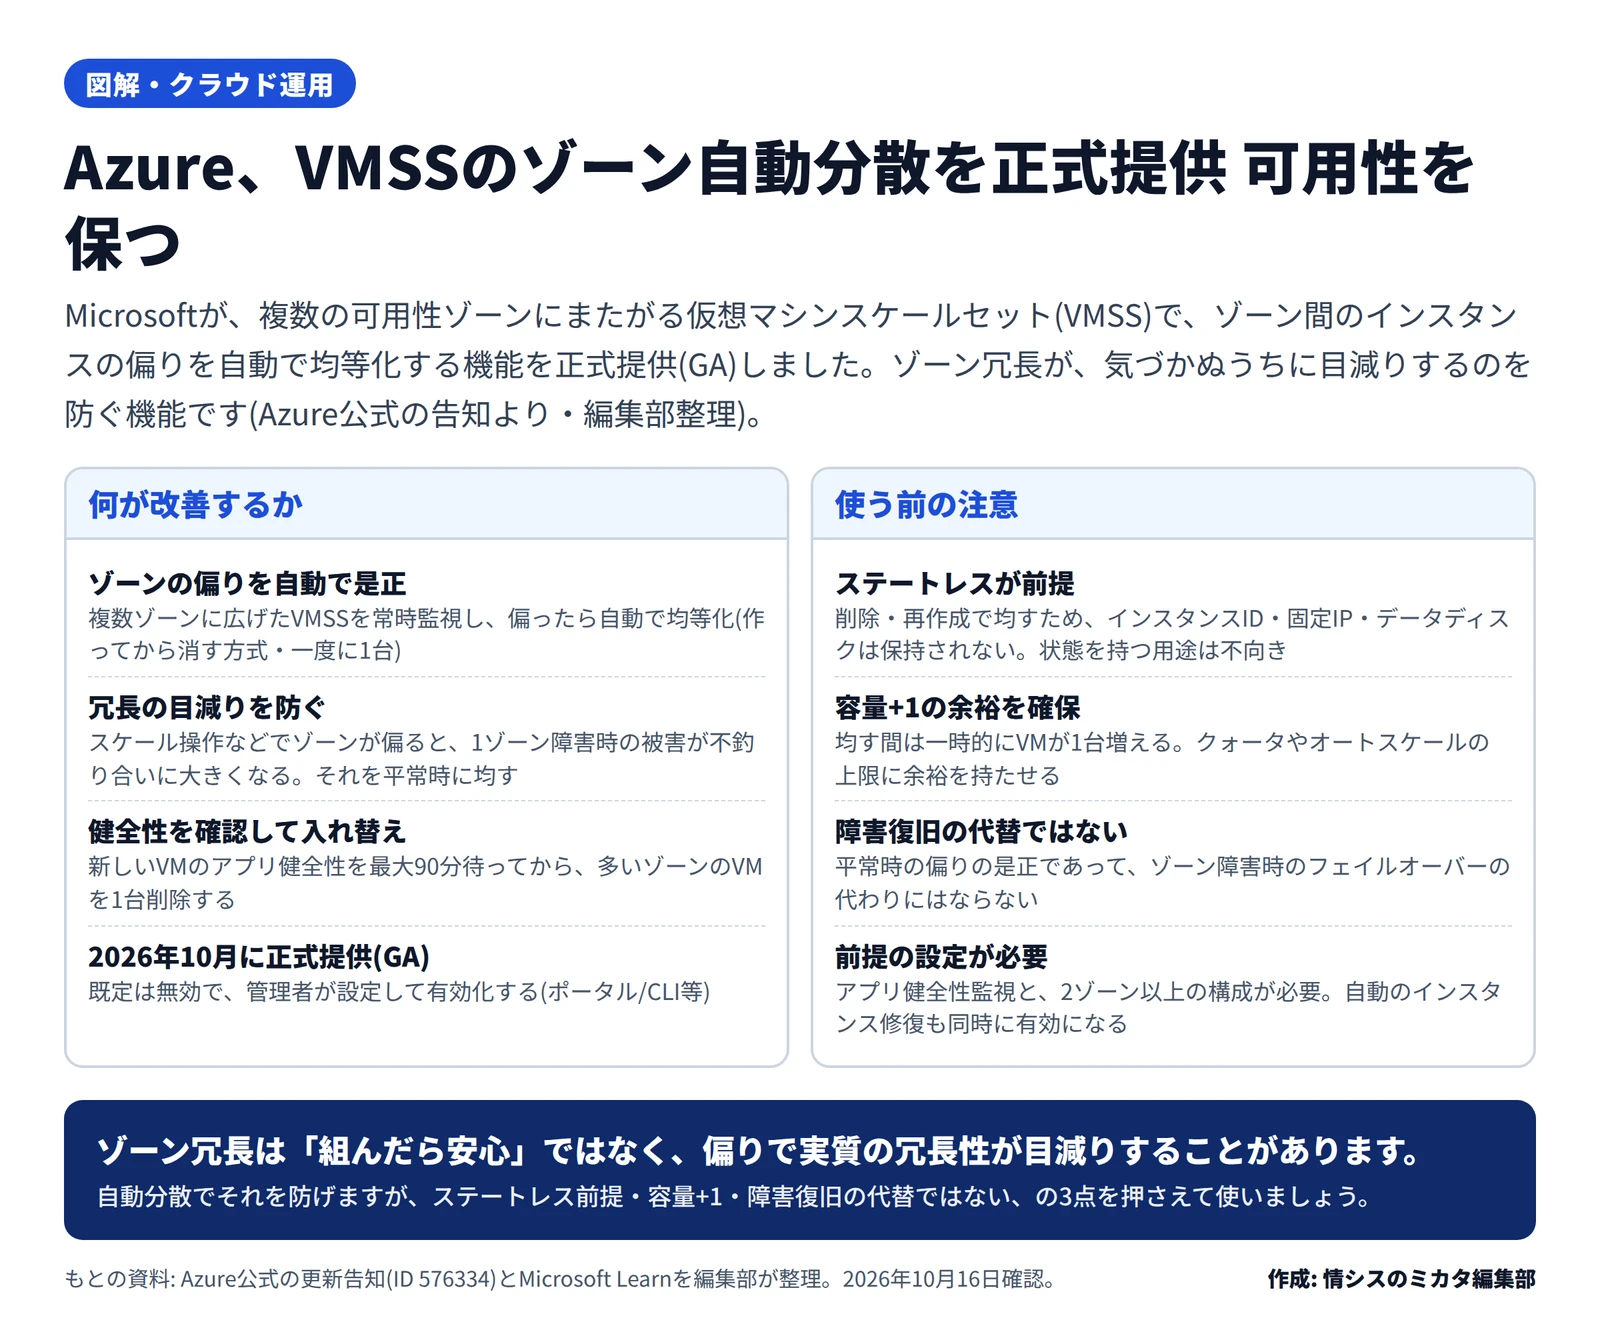
2区画の図。左『何が改善するか』=複数ゾーンに広げたVMSSを常時監視し偏りを自動で均等化(作ってから消す・一度に1台)、スケール操作でゾーンが偏ると1ゾーン障害の被害が大きくなるのを平常時に均す、新VMのアプリ健全性を最大90分待って多いゾーンのVMを削除、2026年10月に正式提供GAで既定は無効。右『使う前の注意』=ステートレス前提(ID/固定IP/データディスクは保持されない)、容量+1の余裕を確保、障害復旧の代替ではない、アプリ健全性監視と2ゾーン以上が前提で自動修復も同時に有効
VMSSのゾーン自動分散の効果と使う前の注意(編集部作成)作成: 編集部 / もとの資料: Azure公式の更新告知(ID 576334)とMicrosoft Learnを編集部が整理

しかし、スケール操作(台数の増減)や容量の制約によって、ゾーンごとのVMの数が偏ることがあります。偏ったまま運用していると、たまたまVMが多く集まったゾーンで障害が起きたときに、不釣り合いに多くのVMが落ちてしまいます。今回の機能は、ゾーンにまたがるVMSSを常時監視し、偏りを検知すると自動で均等化します。方式は「作ってから消す」で、少ないゾーンに新しいVMを作り、その健全性を最大90分確認してから、多いゾーンのVMを1台削除します。一度に動かすのは1台だけです。

影響する会社・しない会社

影響する(役に立つ): Azureで、複数の可用性ゾーンにまたがるVMSSを使って可用性を組んでいる会社。とくに、オートスケールで台数が増減する環境は、知らないうちにゾーンが偏りやすく、この機能の恩恵を受けやすいです。

影響しない・向かない: VMSSやゾーン冗長を使っていない環境。また、状態(データ)をVM自身に持たせているワークロードには向きません(後述)。

使う前の注意

この機能は便利ですが、仕組みを理解せずに有効化すると、思わぬ影響が出ます。次の3点を押さえておきましょう。

  • ステートレスが前提: 偏りの是正は、VMの削除・再作成で行います。インスタンスのIDや固定IP、VMに付けたデータディスクは保持されません。状態をVMに持たせる構成には向きません。
  • 容量に余裕を持たせる: 均している間は、一時的にVMが1台増えます。サブスクリプションのクォータ(上限)や、オートスケールの最大台数・スケールインのルールに、余裕を持たせておく必要があります。
  • ゾーン障害復旧の代替ではない: これは平常時の偏りを均す機能で、ゾーン障害時のフェイルオーバーの代わりにはなりません。Microsoftも、復旧手段として使うべきではないと明記しています。

情シスが今日やること

  1. 対象の棚卸し: 自社のAzure環境で、複数ゾーンにまたがるVMSSを使っているかを確認する。オートスケールを使っている環境は、現在のゾーンごとの台数の偏りも見ておく。
  2. 前提の設定を確認: アプリの健全性監視(Application Health拡張やロードバランサーの正常性プローブ)が設定されているかを確認する。未設定だと、この機能は使えません。
  3. 容量と設計の確認: 一時的な容量+1に耐えるクォータ・上限があるか、ワークロードがステートレスかを確認してから、既定で無効のこの機能を有効化する。
  4. 役割を正しく理解: 障害時の切り替えは別途設計で備える。この機能は「平常時の偏りを均す」ものだと、運用チームで共有する。

「ゾーンに分けたから安心」ではなく、偏りで冗長性が目減りしていないかを見ることが、可用性の維持には欠かせません。自動分散は、その手間を減らす選択肢ですが、前提と限界を理解して使うことが大切です。


よくある質問

Qこれはゾーン障害が起きたときの切り替え機能ですか?

Aいいえ。この機能は、平常時にゾーン間のインスタンスの偏りを均すものです。Microsoftは、ゾーン障害時のVMの健全性は監視せず、ゾーンダウンからの復旧手段として使うべきではないと明記しています。障害時のフェイルオーバーは、別途、設計で備える必要があります。

Qどんな構成で使えますか?

A2つ以上の可用性ゾーンにまたがるVMSSで、アプリの健全性監視(Application Health拡張またはロードバランサーの正常性プローブ)を設定していることが前提です。既定では無効で、ポータルやCLIなどから有効化します。有効化すると、自動のインスタンス修復も同時に有効になります。

出典・参考

チェック済み。この記事は監修者によってチェックされました。(2026年10月16日)

執筆

情シスのミカタ編集部AIにより執筆

書いた AI: AI記者(解説)

法令・官公庁の発表・企業の公式発表などの一次情報を調べて、情シス向けの解説・比較・テンプレの記事を書きます。数字と日付は出典と照らして確かめ、記事の最後に出典を載せています。使っているAI: Anthropic Claude。

監修

佐々木 航株式会社Game

代表取締役。工学部出身で、21歳で起業してからシステム会社の経営一筋で8期目。アプリの受託開発から始め、いまはAIを使ったシステムソリューションを手がけています。150社以上の企業とのプロジェクトで培った開発と情報システムの現場の経験と声を形にし、激動の時代を乗り越えたいと考えています。

メモ: 掲載時に自動で(しばらくの間)

記事は AI が一次情報を調べて書き、機械の検査を通してから公開しています。人が見ているもの・見ていないものはAI の使い方に書いています。まちがいに気づいたら訂正・ご指摘からお知らせください。直したら、記事の最後に何を直したかを書きます。

役に立ったら、いいねと共有をお願いします