AWS は2026年9月30日、Amazon Aurora PostgreSQLで、データレイクにあるApache IcebergとParquet形式のデータを、運用中のデータと一緒に直接検索できるようにしたと発表しました。この機能のエンジンが、PostgreSQLに組み込まれた「DuckDB」です。
これまで、S3にある履歴データをAuroraのアプリで使うには、データをAuroraへ写すパイプライン(ETL)を作るのが一般的でした。今回は、そのパイプラインなしで、PostgreSQLの外部テーブルとして読めます。DuckDBは、分析向けに作られた、オープンソース の列指向のデータベースエンジンです。
何が発表されたのか
公式のAWSの最新情報、AWS News Blog、ドキュメントに書かれている内容は次のとおりです。
項目
公式の内容
発表日
2026年9月30日(AWSの最新情報の投稿日、ブログも同日)
機能
PostgreSQLの外部テーブルから、IcebergとParquetのデータを直接クエリ
読めるデータの置き場
Amazon S3、Amazon S3 Tables、AWS Glue データカタログ
外部のカタログ
Glue データカタログのフェデレーション経由で、Iceberg REST Catalog(IRC)互換のカタログのテーブルも検索可能
対象の版
Aurora PostgreSQL 17.11以降と18.6以降。Aurora Serverless v2を含む(ドキュメント)
リージョン
すべてのAWS商用リージョンと、AWS GovCloud(米国)リージョン
料金
追加料金なし。使った分のAuroraの計算量とS3のリクエスト料金のみ
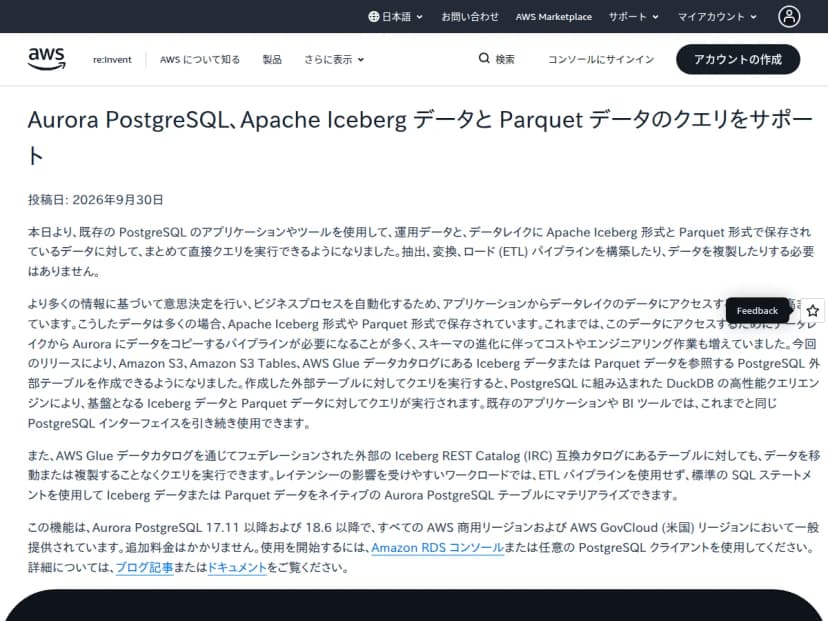
AWSの最新情報。Aurora PostgreSQLがIcebergとParquetの直接クエリに対応した発表 出典: AWS「AWS の最新情報」 (引用) AWS News Blogによると、DuckDBはPostgreSQLのサーバーの中に組み込まれ、クエリの処理はAurora内で完結します。外部へのネットワークの寄り道はありません。ブログには、DuckDBを保守するDuckLabsのチームが最近Amazonに加わったとも書かれています。
設定の流れ
ブログに書かれた手順は、次のとおりです。
17.11以降か18.6以降のAurora PostgreSQLのクラスターを用意します。
AuroraAnalytics の機能を付けたIAMロールをクラスターに付けます。このロールが、S3とGlue データカタログへのアクセスを与えます。
拡張機能 aurora_analytics を有効にします(CREATE EXTENSION aurora_analytics;)。
IcebergかParquetのデータを指す外部テーブルを作り、普通のSQLでクエリします。
設定は、Amazon RDSコンソールか、psqlなどのPostgreSQLクライアントでできます。スキーマはParquetのメタデータから自動で読み取ります。Glue データカタログのデータベースにあるテーブルは、IMPORT FOREIGN SCHEMA で、まとめて外部テーブルにできます。
性能と運用の注意点
公式のブログとドキュメントが書いている、運用に関わる点です。
述語のプッシュダウンと列の絞り込みで、必要なデータだけを読みます。よく使うデータは、Auroraのインスタンスのローカルのストレージにキャッシュされます。
読み取りのクエリは、ライターでもリードレプリカでも動きます。分析のスキャンを、運用の負荷から離せます。
データレイクのデータをAuroraのテーブルに取り込む(CREATE TABLE AS SELECT、INSERT INTO ... SELECT、MERGE INTO)ときは、ライターで動きます。ミリ秒単位の応答が要る用途に向けた使い方として、ブログが挙げています。
クエリごとの動きは、aurora_analytics_stat_statements() で見られます。読んだ行数、S3から読んだバイト数、キャッシュのヒットなどが出ます。
権限は、PostgreSQLのロール、監査ログ、ネットワークの制御が、そのまま外部テーブルへのクエリにも効くと、ドキュメントに書かれています。
There is no additional charge to enable this capability. You pay only for the incremental Aurora compute and Amazon S3 requests that your queries consume.
出典: Amazon Aurora ユーザーガイド
日本での提供と、書かれていないこと
AWSの最新情報は日本語のページで公開されています。日本での提供は、「すべての商用リージョン」に含まれます。東京リージョン、大阪リージョンという名前は、発表にもブログにも出てきません。使うリージョンの対応は、導入前にドキュメントで確認してください。
次の点は、読んだ範囲に書かれていませんでした。
Aurora MySQLや、RDS for PostgreSQL、Aurora DSQLへの対応
16以前のAurora PostgreSQLへの対応(対象は17.11以降と18.6以降と書かれています)
円での料金や、実際のクエリの料金の目安
制限事項は、ドキュメントに専用の節があります。この記事では、その中身は読み込んでいないので書いていません。
影響する会社・しない会社
影響する: Aurora PostgreSQL 17か18を使っていて、S3にParquetやIcebergのデータを置いている会社。外部テーブルで読めます。
影響する: データレイクからAuroraへ、画面表示や集計のためだけにデータを写す、定期のパイプラインを持っている会社。作り直しの候補になります。
影響する: 古い履歴データをS3に移し、Auroraの容量とバックアップを減らしたい会社。ドキュメントのデータの階層化の使い方に当たります。
影響しない: Aurora MySQLだけを使っている会社。対象は、Aurora PostgreSQLと書かれています。
影響しない: Aurora PostgreSQLの16以前で、版を上げる予定がない会社。対象の版に入っていません。
影響しない: データレイクがなく、データがAurora内で完結している会社。使わなくて困ることはありません。
情シスが今日やること
Auroraのクラスターの版を一覧にします。 RDSコンソールでエンジンと版を確認し、17.11以降か18.6以降かを台帳に書きます。本番と検証、東京と大阪の別も付けます。データレイクからAuroraへ写している処理を洗い出します。 夜間のバッチ、ETLのジョブ、Glueのジョブを見て、「読むだけの用途」のものを候補に挙げます。開発の担当に確認します。IAMロールの範囲を先に決めます。 AuroraAnalytics 用のロールは、S3のバケットとGlue データカタログへのアクセスを与えます。読んでよいバケットとプレフィックスだけに絞り、情報管理の担当と確認します。検証用のクラスターで試します。 本番ではなく、検証用で拡張機能を有効にし、小さなParquetファイルで外部テーブルを作ります。レプリカで読んだときの負荷と、S3のリクエスト数を見ます。版を上げる日を決めます。 対象外の版を使っている場合は、メンテナンスの時間と戻し方を決め、AWSの発表のリンクとあわせて、アプリの担当に共有します。