Googleは2026年10月21日付の発表で、BigQuery ObjectRefと、画像や音声などを組み合わせるマルチモーダルデータ分析の正式提供を発表しました。Cloud Storageにあるファイルを複製せず、通常の表データと合わせて分析できます。ObjectRefは全BigQueryエディションとオンデマンド料金体系で提供されます。
ファイルを移さず、表の列として参照する
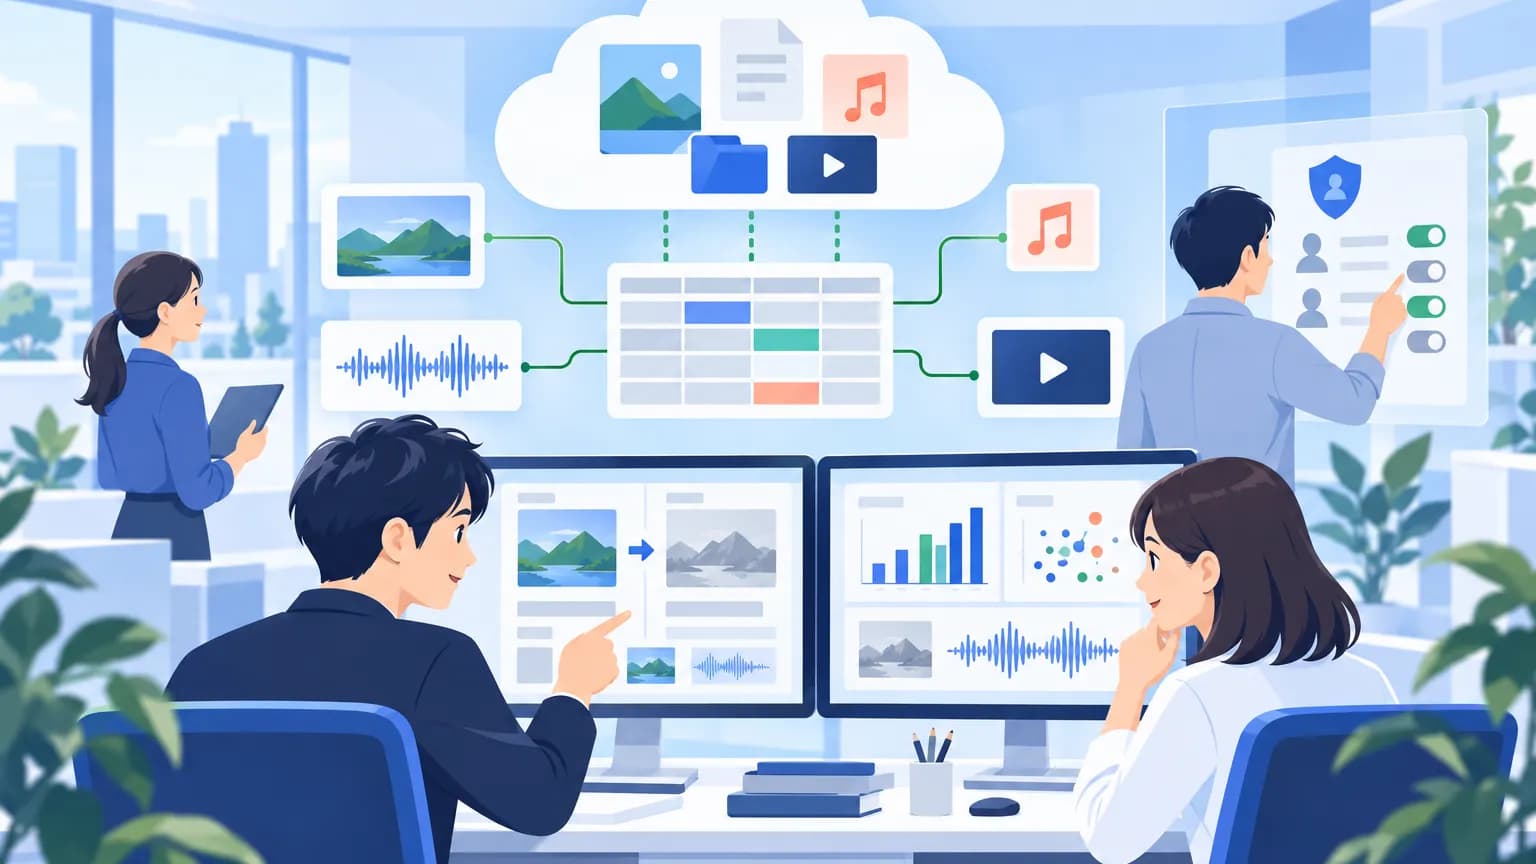
ObjectRefは、BigQueryの外にあるオブジェクトを参照する組み込みのSTRUCT型です。STRUCT型は、複数の項目をまとめて扱うデータ型です。Googleによると、画像や音声などへの参照を、通常の列と同じテーブルに格納できます。ファイル本体はCloud Storageに置いたまま扱います。
分析には、データを検索・集計する言語である標準SQLや、BigQuery DataFramesを使えます。複数列の入力を単一のSQLでGeminiに渡せるほか、正式版では配列内のObjectRefの処理にも対応しました。複数のファイルを1回のGemini呼び出しに渡し、比較分析できます。
抽出結果と元ファイルへの参照を同じ行に残せる点も特徴です。分析結果だけでなく、その根拠となるファイルをたどる構成にできます。世代番号の追跡にも対応し、更新前のファイルの特定版を参照できます。
Googleは、別の計算クラスターを用意せず、画像や音声などの非構造化データを処理する基盤を構築できると説明しています。ObjectRefはBigQuery AI、会話型分析、Gemini Enterpriseとも連携します。
個人での探索と本番処理で接続方式を分ける
正式版では、End User Credentials(EUC)への対応が加わりました。これは利用者本人の認証情報を使う仕組みです。個人のIAM IDで非構造化データを直接探索できます。IAMは、誰にどの操作を許可するかを管理する仕組みです。
一方、従来の明示的なBigQuery接続も引き続きサポートされます。Googleは、継続的にデータを処理する本番パイプラインには、この接続方式を推奨しています。個人で試す際の接続方法を、そのまま本番の設計にするのではなく、用途ごとに整理することが検討の要点です。
既存のBigQueryポリシーとIAMで、関連ファイルへのアクセスも管理できるとしています。また、Cloud StorageとBigQueryのデータは独立して管理できます。分析側の権限だけでなく、参照先のファイルとその管理担当も合わせて確認する必要があります。
日本での提供は発表には書かれていません。日本のリージョンでの利用可否、日本語対応、日本向けの価格も記載されていません。
影響する会社・しない会社
- 影響する: BigQueryを利用し、Cloud Storageの画像や音声を表データと合わせて分析したい会社です。ファイルを複製せず参照できるため、分析用データの置き方を検討する際の選択肢になります。
- 影響する: BigQueryテーブルにファイルの保存先を示す文字列URIを保持している会社です。通常のテーブル内の文字列URIからもObjectRefを作成できるため、既存の列を確認する価値があります。
- 影響しない: 対象外となる会社の規模や業種、地域の条件は、発表には書かれていません。少なくともエディションによる対象の限定はなく、オンデマンド料金体系も提供対象です。
情シスが今日やること
導入を検討する場合は、次の順で確認すると、試行と本番の条件を分けて整理できます。
- 今日、BigQueryの管理担当に、対象テーブルの列定義を確認してもらいます。Cloud Storageの保存先を示す文字列URIがあるか、対応するファイルを誰が管理しているかを一覧にします。新しい分析対象を探す前に、既存データから候補を絞ります。
- 試行前に、対象テーブルのBigQueryポリシーと、参照するファイルのIAM権限を管理担当と確認します。利用者本人のIDで探索する場合と、本番処理で利用する場合を分け、誰に何を読ませるかを決めます。
- 分析担当に、少数の対象ファイルでの検証を依頼します。抽出結果と元ファイルへの参照を同じ行に残し、結果から元資料を確認できるかを点検します。更新前の版を参照する必要がある業務では、世代番号も確認対象にします。
- 本番設計を決める前に、クラウド契約・運用担当へ利用条件の確認を依頼します。日本での提供状況、利用するリージョン、料金を確認し、接続方式はGoogleが本番向けに推奨する明示的なBigQuery接続を検討します。